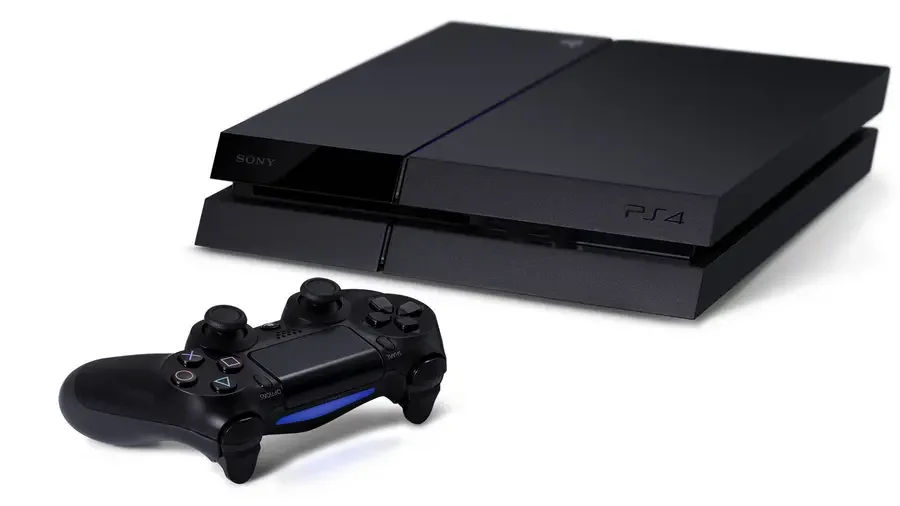
Проект с открытым исходным кодом Garlic LLM от разработчика Леонардо Алегреа позволяет запущенной на взломанной PS4 программе запускать ИИ-модель Qwen3.5-9B с 9 миллиардами параметров офлайн на графическом процессоре консоли 2013 года выпуска. Приложение напрямую взаимодействует с GPU, а модель сжата примерно до 4,5 ГБ, чтобы поместиться в памяти консоли, работая со скоростью от 31 до 39 токенов в секунду.
Проект, названный в честь памяти, к которой GPU имеет прямой доступ (его родственный тип памяти — «Onion»), требует наличия PS4 с установленной GoldHEN — программой для запуска самодельного ПО на взломанных консолях. Garlic LLM распространяется бесплатно, одним файлом размером 5,66 ГБ, доступен на Hugging Face и устанавливается через Package Installer консоли PS4. Для установки требуется около 6 ГБ свободного места, или 12 ГБ, если пакет сначала копируется на внутренний диск консоли. Разработчик тестировал его на базовой модели/Slim PS4 с прошивкой 11.52.
Программа способна поддерживать голосовые беседы с ответами на семи языках с помощью речевой модели Chatterbox и чат-модели, работающей со скоростью около 22 токенов в секунду. Удерживаемая кнопка контроллера также позволяет использовать диктовку с помощью модели преобразования речи в текст Nvidia Parakeet TDT 0.6B v3, которая поддерживает 25 европейских языков. Модели Parakeet также используются в локальных приложениях для транскрипции и диктовки, таких как Meetily и Hex. Основная модель — это небольшой открытый весовой вариант Qwen3.5-9B от Alibaba, который при заявленной скорости от 31 до 39 токенов в секунду в текстовом чате (метод запроса и тестирования не указаны) пригоден для использования на консоли.
Наиболее близким аналогом является форк PS5LM, который запускает llama.cpp как нативное приложение на PS5 и получает доступ к графическому процессору консоли AMD через PS5_Vulkan — порт драйвера RADV. llama.cpp с открытым исходным кодом — широко используемая программа для локального запуска языковых моделей, а RADV — драйвер с открытым исходным кодом, позволяющий графическим процессорам AMD запускать Vulkan — графический API и API для вычислений. На PS4 нет такого слоя драйверов для самодельного ПО; Garlic LLM не использует ни llama.cpp, ни порт Vulkan, по крайней мере, так кажется.
Операции модели, такие как матричные умножения над 4-битными весами, представляют собой вычислительные ядра, написанные на OpenCL C и скомпилированные с помощью LLVM для архитектуры Graphics Core Next (GCN) от AMD. Веса хранятся в этой памяти «Garlic», в то время как сторона ЦП, написанная на обычном C, обрабатывает токенизатор, интерфейс, рендеринг текста и аудио. Конвейер работает от запроса к токенизатору ЦП, затем для каждого токена — буфер команд PM4 (низкоуровневые команды, которые обычно генерирует графический драйвер, но в данном случае приложение создает сам) и ядра GCN, прежде чем токен будет отображен или озвучен. Все это собрано с использованием инструментария OpenOrbis PS4 с открытым исходным кодом.
Первый очевидный вопрос: как уместить модель с 9 миллиардами параметров в 8 ГБ памяти консоли, которую совместно используют ЦП и ГП? При 8 битах на вес получается один байт на параметр, что означает необходимость как минимум 9 ГБ, а обычно и больше в целом. Частичный ответ — 4-битные (Q4) веса, которые занимают вдвое меньше места, хотя для двух самых больших матриц в каждом слое используются 3-битные (Q3) веса, примерно 3,5 бита с масштабированием.
Использование этой комбинации позволяет получить около 4,5 ГБ по сравнению с примерно 4,9 ГБ, если бы все было 4-битным. Кэш внимания, или KV-кэш, также имеет 4-битную разрядность, что позволяет вместить контекст размером 16 тыс. токенов по сравнению с нативными 256 тыс. токенов модели. Модель диктовки Parakeet добавляет 0,33 ГБ, а голосовые модели Chatterbox — 0,29 ГБ и 0,09 ГБ, что в сумме составляет 5,23 ГБ или 5,62 ГБ, что близко соответствует размеру пакета 5,66 ГБ.
Следующий вопрос — производительность. Qwen3.5 поставляется с головкой многотокеновой предсказательной модели (MTP), и Garlic LLM использует ее для подготовки до двух токенов вперед, с проверкой полной моделью. Это соответствует тому, для чего модель была обучена, и инструкции vLLM на карточке модели Alibaba используют два спекулятивных токена. Проект приписывает это своей скорости чата на оборудовании 2013 года.
Код также генерируется быстрее с этой настройкой, со скоростью до 43 токенов в секунду. Также подробно описана температура по умолчанию, или вариативность модели, которая составляет 0,7 (Alibaba рекомендует 0,7 для общих задач с отключенным мышлением и 1,0 с включенным), хотя в демонстрационном видео используется 0, что делает вывод предсказуемым. При 35 токенах в секунду, что является серединой заявленного диапазона производительности, ответ из 300 токенов занимает менее девяти секунд. Для сравнения, PS5 обрабатывала в три раза большую модель Qwen3.8-27B со скоростью около 20 токенов в секунду, а меньшие модели Gemma 4 E4B и Llama 3.2 3B — со скоростью 61 и 124 соответственно, что потенциально быстрее.
PS4 Pro «еще не тестировалась», но разработчик просит пользователей сообщать о результатах на GitHub. PS5 не поддерживается, так как приложение написано специально для графического процессора и системного программного обеспечения PS4. Само приложение не содержит эксплойтов, но установка GoldHEN осуществляется на ваш страх и риск.
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Shane Downing