
Лаборатория Thinking Machines представила Inkling 2 Mini — удивительно мощную новую ИИ-модель с открытым весом, содержащую всего 26 миллиардов параметров, но демонстрирующую впечатляющую производительность в задачах кодирования, рассуждений и работы в качестве агента. Важнее всего то, что модель может работать полностью офлайн на потребительском оборудовании, включая Apple MacBook с 32 ГБ унифицированной памяти.
Анонсированная 20 ноября, Inkling 2 Mini является значительно меньшей альтернативой массивной модели компании Inkling 2 Small с 594 миллиардами параметров. Однако вместо простого уменьшения существующей архитектуры Thinking Machines применила интересный подход, который позволяет новой модели выполнять дополнительные рассуждения без генерации большего количества токенов.
Результаты обнадеживают: модель получила оценку Artificial Analysis (AA) Intelligence Index 20,1, а также продемонстрировала конкурентоспособную производительность по сравнению со значительно более крупными ИИ-моделями.
Inkling 2 Mini использует циклическую архитектуру трансформера для обеспечения впечатляющей производительности рассуждений всего с 26 миллиардами параметров
Согласно официальному техническому анонсу Thinking Machines, Inkling 2 Mini использует 24-слойную архитектуру трансформера Mixture of Experts (MoE) с общим числом параметров 26,4 миллиарда и лишь 3,4 миллиарда активных параметров.
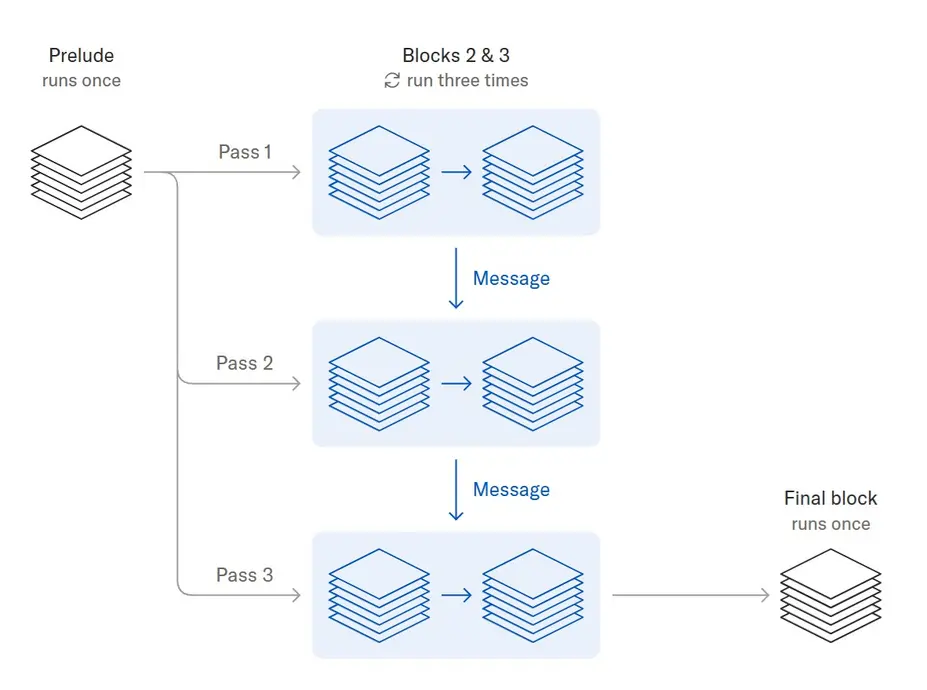
Что делает эту архитектуру особенно интересной, так это способ обработки информации. Вместо того чтобы пропускать каждый токен через каждый слой трансформера только один раз, модель выполняет свои средние 12 слоев трижды, в то время как первые и последние шесть слоев работают нормально.
Следовательно, модель выполняет 48 применений слоев на токен, несмотря на хранение весов только для 24 слоев. Это увеличивает ее эффективное количество активных параметров до 5,4 миллиарда на токен, позволяя выполнять дополнительные вычисления без пропорционального увеличения требований к памяти.
Проще говоря, Inkling 2 Mini может эффективно тратить больше времени на внутренние рассуждения перед генерацией следующего токена.
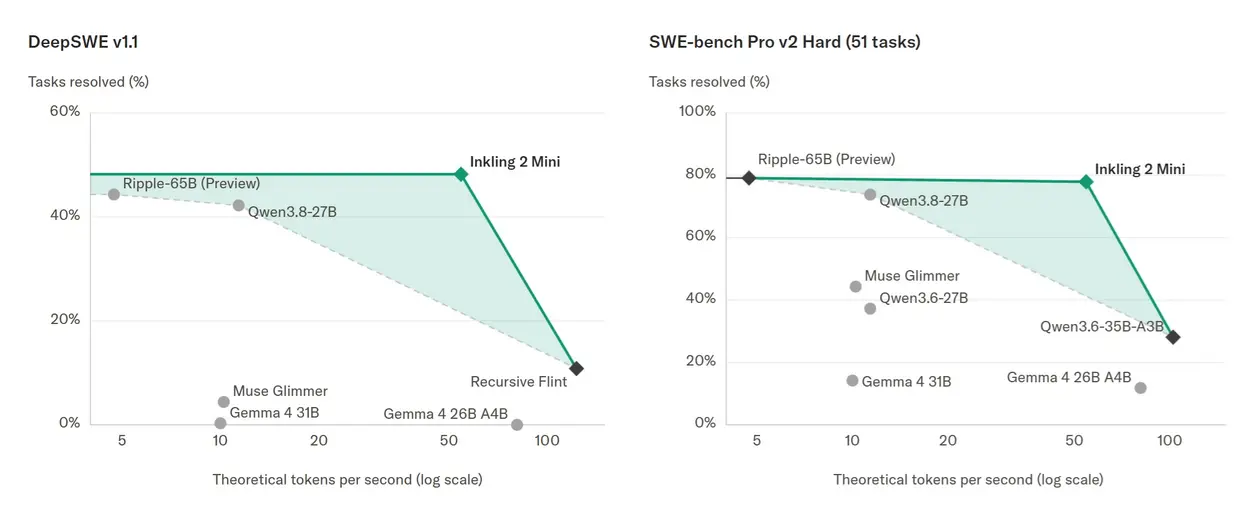
Компания утверждает, что такой подход обеспечивает особенно впечатляющие улучшения в области кодирования с использованием агентов. Inkling 2 Mini показал результат 48,2% на DeepSWE v1.1 по сравнению с 42,2% у Qwen3.8-27B, в то время как его результат на SWE-bench Pro v2 Hard достиг 77,9%, превзойдя 73,8% последнего.
Он также показал результат 46,5% на Vals Index v2.2 и 79,2% на SWE-bench Verified. Это результаты оценки, предоставленные компанией, и различия в конфигурациях тестирования означают, что их не следует интерпретировать как универсальные преимущества в производительности.
Интересно, что Thinking Machines обучала Inkling 2 Mini на платформе NVIDIA GB300 Grace Blackwell Ultra, используя ее аппаратное ускорение NVFP4 для повышения эффективности обучения. Большая часть весов модели была обучена с использованием 4-битной точности NVFP4, а последние четыре слоя использовали 8-битную точность MXFP8. Поскольку эти веса развертываются в той же числовой точности, что и при обучении, компания заявляет, что модель избегает дополнительных потерь при преобразовании, связанных с пост-тренировочной квантизацией.
Inkling 2 Mini работает офлайн с объемом памяти 20 ГБ, в то время как исследователи изучают его скрытые рассуждения
Пожалуй, самым захватывающим аспектом Inkling 2 Mini является его доступность. Несмотря на свои возможности, модель имеет объем памяти около 20 ГБ, что позволяет ей работать на Mac с Apple Silicon с объемом унифицированной памяти не менее 32 ГБ через Ollama.
Официально поддерживается также настольный ИИ-компьютер NVIDIA DGX Spark, возможны и другие конфигурации GPU, рекомендуется 32 ГБ или более VRAM. Модель поддерживает ввод текста и изображений, а также контекстное окно до одного миллиона токенов.
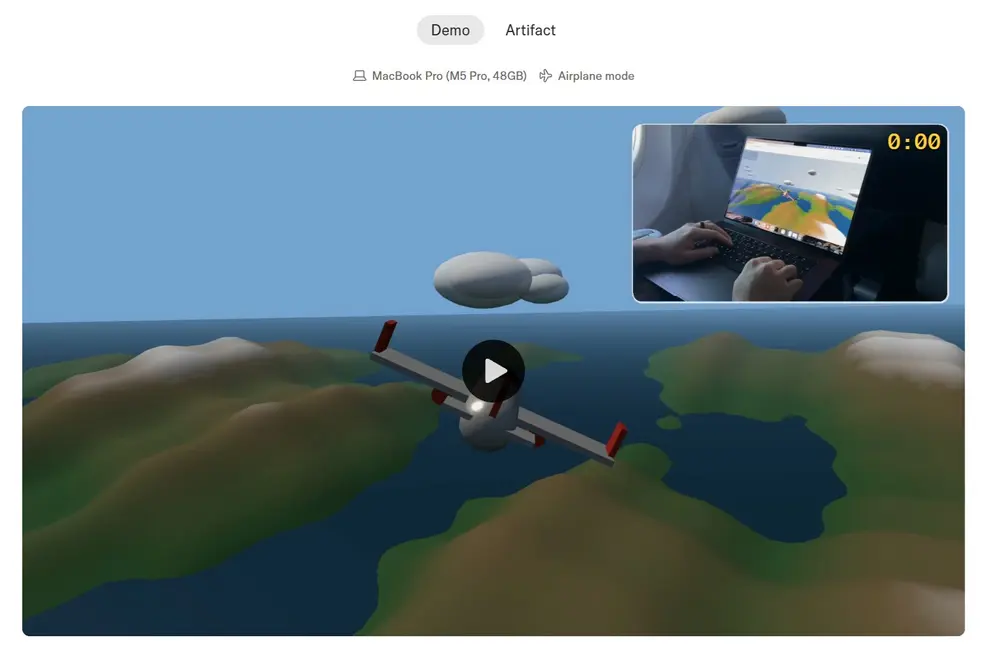
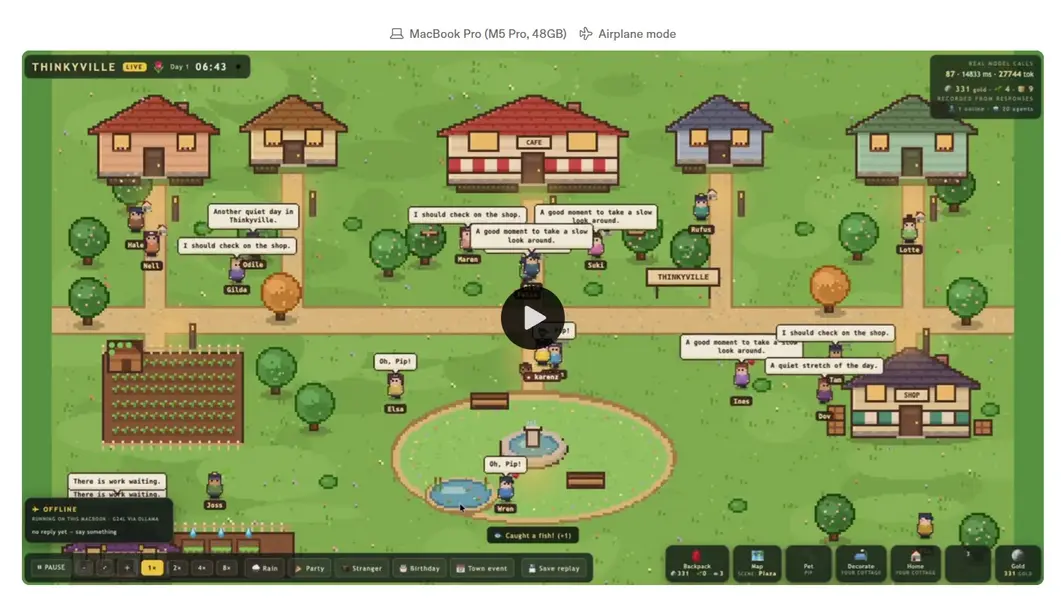
Чтобы продемонстрировать свои возможности, Thinking Machines показала Inkling 2 Mini, работающий полностью офлайн на MacBook Pro M5 Pro с 48 ГБ памяти. Сообщается, что во время полета модель сгенерировала играбельный авиасимулятор всего за несколько минут.
Однако архитектура поднимает важный вопрос, касающийся безопасности и прозрачности ИИ.
Поскольку циклические трансформеры могут выполнять дополнительные вычисления внутренне, не записывая явно каждый шаг рассуждения, исследователи выразили обеспокоенность по поводу того, становится ли их поведение более трудным для мониторинга.
Thinking Machines исследовала это с помощью отдельной исследовательской модели с переменным циклом и обнаружила, что дополнительные проходы увеличивают способность модели решать проблемы без генерации письменной цепочки рассуждений. Ее измеренный горизонт задач без цепочки рассуждений увеличился с 16 секунд при одном проходе до 37 секунд при трех.
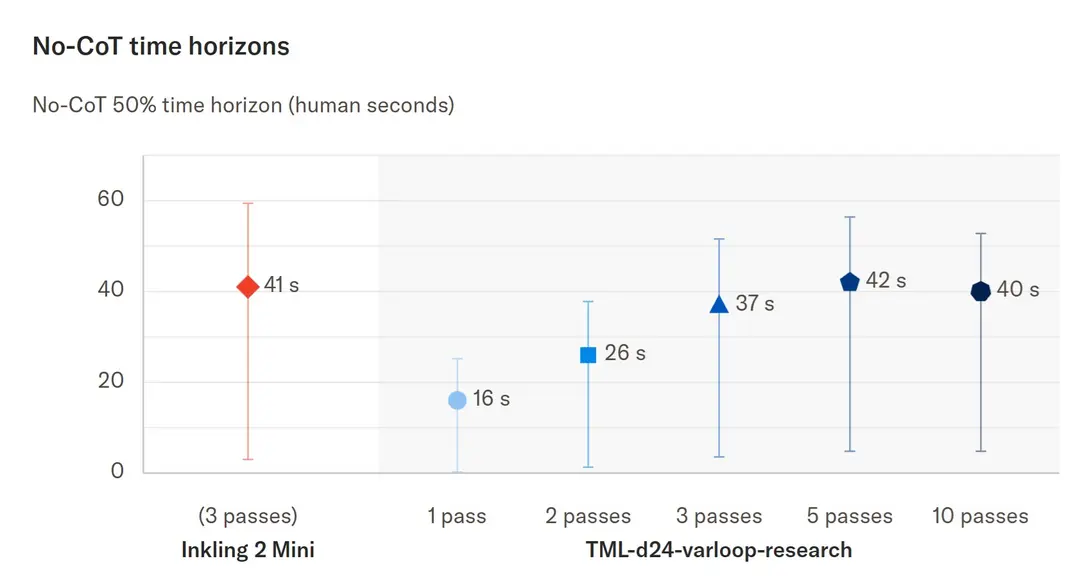
Тем не менее, эксперименты компании показали, что письменные рассуждения модели оставались понятными, без существенного снижения возможности мониторинга в этом масштабе. Исследователи также признали ограничения, включая более слабую производительность в сложных многоходовых диалогах и инструкциях, включающих многочисленные ограничения.
Inkling 2 Mini теперь доступен под лицензией Apache 2.0, с загружаемыми весами на Hugging Face, локальным развертыванием через Ollama, а также инференсом и дообучением через платформу Tinker от Thinking Machines.
Для разработчиков, заинтересованных в локальном запуске мощных ИИ-агентов вместо исключительно облачной инфраструктуры, Inkling 2 Mini представляет собой еще одно интересное развитие в области повышения доступности передовых ИИ-моделей.
Источник новости: Thinking Machines
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Sebastian Castellanos


