Десятилетиями список Top500 неустанно ранжировал крупнейшие, самые мощные и зачастую самые уникальные общеизвестные суперкомпьютеры мира.
С появлением генеративного ИИ список перестал соответствовать своему названию. Китайский суперкомпьютер Lineshine, демонстрирующий 2,2 эксафлопс вычислений с двойной точностью в бенчмарке High-Performance Linpack (HPL), может и занимает первое место в полугодовом рейтинге, но он далеко не самый крупный вычислительный кластер в мире.
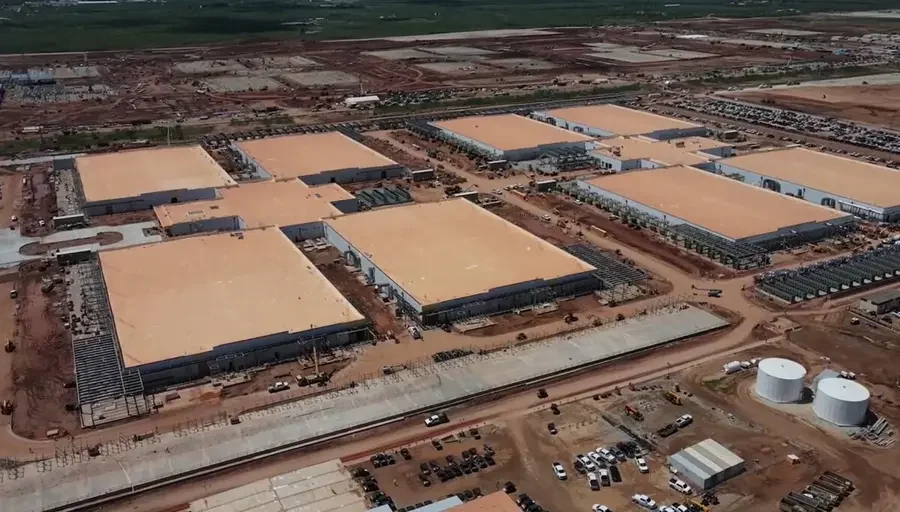
Суперкластеры, такие как Colossus от SpaceXAI, Promethius от *Meta и Stargate от OpenAI, оснащены сотнями тысяч GPU, затмевая все, что представлено в Top500 сегодня.
«Эти [компании] не заинтересованы в подаче заявок в Top500», — заявил Торстен Хёфлер из ETH Zürich на своей конференции Supercomputing на этой неделе.
Это дилемма, с которой сейчас сталкиваются основатели рейтинга Top500. И некоторые считают, что настало время переосмыслить подход.
«Для более адекватного отслеживания требуется не только другой бенчмарк, но и другая методология», — сказал автор Top500 Эрих Штромайер.
Штромайер объясняет, что долгое время вычислительная мощность была примерно сопоставима с емкостью.
«В последние несколько лет с развитием ИИ емкость действительно опередила мощность с точки зрения рыночного размера», — сказал он. «Мы были и остаемся очень сосредоточенными на мощности».
Под мощностью Штромайер подразумевает способность запускать один код на всем кластере.
«Наше главное правило для бенчмаркинга заключается в том, что вы должны тестировать всю свою систему с помощью одного кода, и вы не можете просто сложить две части, чтобы получить число», — пояснил он.
Это проблематично для крупных кластеров, которые крупные гиперскейлеры и облачные провайдеры сейчас строят для поддержки бума ИИ. «Все эти системы — системы емкости», — сказал Штромайер.
Они не предназначены для запуска одной программы, а спроектированы для выполнения множества мелких или средних инстанций кода, которые могут включать обучение, дообучение, обучение с подкреплением и, конечно же, инференс.
Из-за этого, по словам Штромайера, было бы неразумно ожидать, что SpaceXAI запустит что-то вроде High-Performance Linpack (HPL) на кластере вроде Colossus.
Но эти кластеры по-прежнему стоит отслеживать. Просто для них понадобится новый бенчмарк, лучше подходящий для оценки возможностей этих массивов и в то же время предотвращающий манипуляции со стороны операторов.
Какую форму примет такой бенчмарк, покажет время. Разработка нового бенчмарка или методологии — непростая задача, и изменение существующих бенчмарков не является идеальным решением. «Если мы что-то изменим в самом бенчмарке, мы потеряем исторические тенденции, что чрезвычайно ценно», — сказал Хёфлер.
Разрешение более низких точностей — HPL-MxP уже в некоторой степени это делает — является одним из путей решения проблемы того, что эти ускорители все чаще обменивают производительность FP64 на типы данных с плавающей запятой меньшей точности, такие как FP8 или FP4.
Другой путь — разработка отдельного бенчмарка для ИИ. Он был бы немедленно применим к этим кластерам, но учитывая темпы изменений в архитектуре моделей, создание такого бенчмарка является сложной задачей.
«Рабочие нагрузки ИИ меняются каждые две недели, поэтому, если вы выберете что-то сегодня, оно станет неактуальным максимум через год, а эти бенчмарки должны существовать десятилетиями», — сказал Хёфлер. ®
*Facebook, *Instagram и *WhatsApp принадлежат компании *Meta Platforms Inc., деятельность которой признана экстремистской и запрещена на территории Российской Федерации.
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Tobias Mann