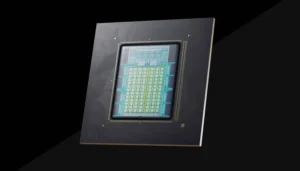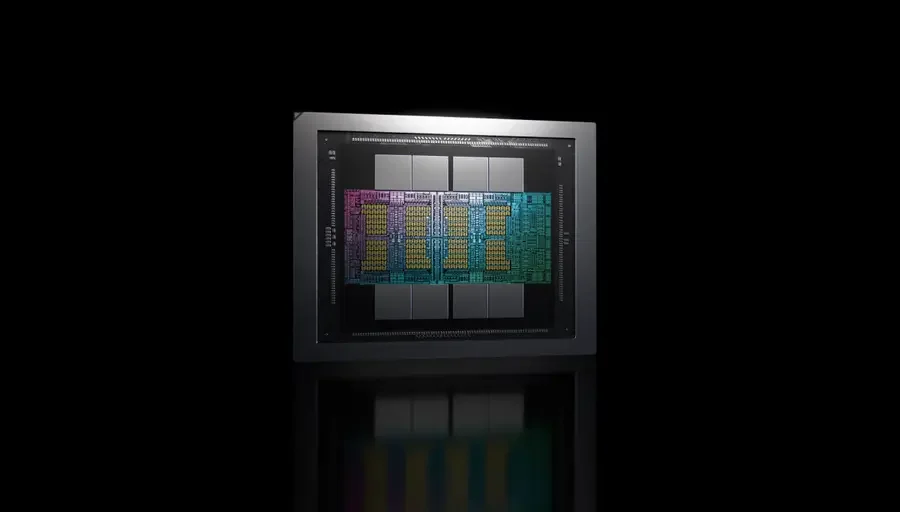
На этой неделе на выставке Supercomputing 2026 компания Nvidia представила новый вариант своих GPU Rubin, предназначенный для — вы никогда не поверите — высокопроизводительных вычислений (HPC).
Новый GPU под названием Rubin HPC обещает более 50 000 ядер CUDA, что почти вдвое больше, чем у версии чипа, ориентированной на ИИ, которую Nvidia представила ранее в этом году. Он появится в продаже в 2028 году.
По словам Дэна Эрнста, старшего директора Nvidia по суперкомпьютерам, новый чип предлагает перебалансированную архитектуру, оптимизированную для задач моделирования, инжиниринга и высокопроизводительной аналитики, распространенных в сообществах HPC и научных вычислений.
Это не первый случай, когда Nvidia выпускает специализированное оборудование. В прошлом году компания оптимизировала свой ускоритель B300 для задач инференса ИИ.
«Rubin HPC — это та же идея, — сказал Эрнст изданию El Reg. — В рамках платформы Rubin мы создаем варианты, которые действительно ориентированы на конкретную подобласть приложений».
Подробности остаются скудными. Nvidia не раскрыла пиковую производительность, объем памяти или пропускную способность. Тем не менее, чип, вероятно, будет включать функции, демонстрирующие, что Nvidia может мыслить не только в области ИИ и по-прежнему заботится о сообществе HPC.
Опасения, что Nvidia может игнорировать HPC, вполне обоснованы, поскольку с момента запуска Blackwell Ultra (B300/GB300) компания отказалась от ускорения матриц с двойной точностью в пользу более высокой пропускной способности при более низких точностях.
В результате получился чип, который при FP4 выдавал 15 петафлопс вычислительной мощности для ИИ, но всего 1,3 терафлопс при FP64. Это хорошо для ИИ, но менее полезно для ученых.
Когда Nvidia представила Rubin, казалось, что производитель GPU продолжит эту тенденцию. При 33 терафлопс чип был не только медленнее при FP64, чем GPU Blackwell, которые он заменял, но и медленнее, чем четырехлетние ускорители Hopper от Nvidia.
Nvidia утверждала, что для разреженных весовых нагрузок, измеряемых бенчмарком High Performance Conjugate Gradients (HPCG), более высокое соотношение пропускной способности памяти к вычислительной мощности должно обеспечить значительный прирост производительности.
Между тем, для плотных матричных нагрузок, для которых репрезентативны такие бенчмарки, как High-Performance Linpack (HPL), Nvidia применила новую стратегию: эмуляцию FP64.
Мы подробно обсуждали плюсы и минусы этой техники ранее в этом году, но вкратце: она использует алгоритм, производный от так называемой схемы Озаки.
Алгоритм работает путем разложения матричных операций FP64 на цепочку операций INT8, которые при выполнении на тензорных ядрах Nvidia достигают производительности выше нативной.
Нам сообщили, что Nvidia не использует INT8, но добивается существенного прироста производительности, по крайней мере, для определенных рабочих нагрузок. По данным Nvidia, Rubin может выдавать до 200 эмулированных терафлопс матричных операций FP64.
Хотя Эрнст не предоставил никаких конкретных данных, он заверил нас, что аппаратное обеспечение Nvidia для HPC должно обеспечивать нативную производительность матричных операций FP64, и клиентам не придется полагаться исключительно на эмуляцию.
Оценить векторную производительность нового чипа гораздо проще. Имея более 50 тысяч ядер CUDA (по нашим расчетам, их должно быть около 53 248), чип должен обеспечивать как минимум на 86% более высокую векторную производительность при двойной точности.
HPC-решения от AMD
AMD также разрабатывает новые HPC-чипы. В записи в блоге, опубликованной на прошлой неделе, AMD представила версию своих GPU серии MI400, настроенную для HPC.
Instinct MI430X оснащен 432 ГБ HBM4, 23 ТБ/с пропускной способности памяти и впечатляющими 288 терафлопс пиковой производительности при двойной точности.
AMD не полагается на эмуляцию FP64. Вместо этого AMD использовала свою модульную чиплетную архитектуру для создания двух различных версий своих ускорителей серии MI400: одна оптимизирована для ИИ, а другая разработана для превосходной работы в задачах HPC и научных вычислений.
AMD поделилась прогнозами относительно производительности чипов в нескольких ключевых бенчмарках Top500. Вполне предсказуемо, компания заявляет, что системы, такие как Alice Recoque от EuroHPC и будущий суперкомпьютер Discovery в Национальной лаборатории Ок-Ридж, получат значительный прирост производительности при обновлении с предыдущих решений на базе Instinct MI300A и MI250X. ®
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Tobias Mann