В ответ на новый закон Европейского Союза, платформы искусственного интеллекта внедряют новые схемы для маркировки генерируемого контента. Компания Anthropic недавно сообщила, что её будущие модели Claude будут использовать SynthID-Text — подход, разработанный Google и выпущенный в виде открытого исходного кода. Он использует секретный ключ, который незаметно изменяет процесс выбора моделью следующего слова в предложении. Например, вместо выбора наиболее вероятного слова «облачно» ключ может изменить его на «пасмурно». Любой, кто знает ключ, может определить, был ли текст сгенерирован платформой, использующей его.
Новое исследование показывает, что SynthID-Text может влиять не только на выбор слов, но и на инструменты, которые вызывает модель, а также на вероятность того, что она будет придерживаться или игнорировать защитные механизмы, которым её обучали. Угроза может возрасти при использовании «враждебных» запросов (adversarial prompt), когда злоумышленник пытается заставить модель выполнить вредоносное действие, например, раскрыть пароль или другую конфиденциальную информацию. Инструкции, которые обычно не выполнялись бы, в некоторых случаях будут выполнены после развертывания водяных знаков. Этот вывод подчеркивает необходимость для разработчиков тщательно тестировать поведение своих больших языковых моделей (LLM) и агентов при наличии водяных знаков.
Изменение поведения в области безопасности
«По сравнению с теми же моделями без водяных знаков, это определенно изменит их поведение, особенно когда мы помещаем их в условия враждебных атак или заставляем модели вызывать инструменты при работе в качестве агента», — рассказала Ars Андреа Сипосова, исследователь в области безопасности ИИ в Lasso Security. «Водяные знаки созданы так, чтобы быть незаметными для читателя, но мы знаем, что когда мы что-либо меняем в том, что генерирует модель, это приведет к компромиссам, это проявится где-то».
Водяные знаки работают путем встраивания сигнала, который позволяет идентифицировать вывод как сгенерированный ИИ, что известно как происхождение (provenance). SynthID берет обычный процесс выборки и добавляет к нему генератор случайных начальных чисел, алгоритм выборки и функцию оценки. Вместо использования произвольного генератора случайных чисел для выбора следующего слова, водяные знаки используют секретный ключ. Хотя выбор слова по-прежнему случаен, люди, знающие ключ, могут проверить последовательность слов, чтобы определить вероятность использования ключа.
,
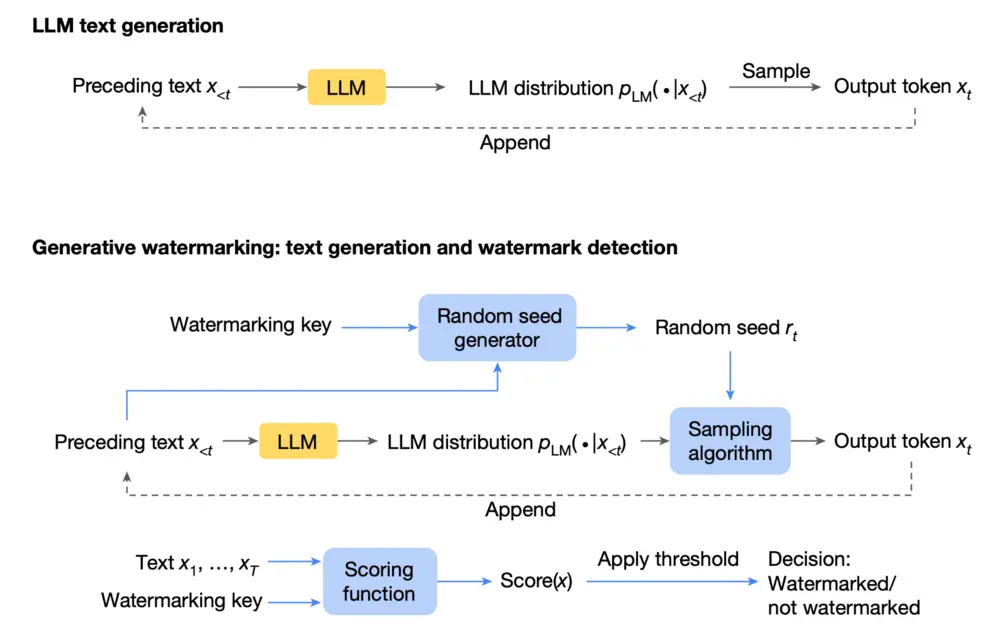
Ключевой особенностью SynthID является так называемая выборка в формате турнира (tournament sampling). Подобно спортивной игре, SynthID оценивает большое количество кандидатов на следующий токен (слово). Он использует секретный ключ для присвоения им вероятностных оценок. Пара токенов соревнуется в раунде. Тот, у кого более высокий скрытый балл, выигрывает и проходит в следующий раунд. Процесс продолжается до тех пор, пока не будет определен финальный выигрышный токен. Подробнее о выборке в формате турнира можно узнать здесь и здесь.
Сипосова протестировала «неискажающую» конфигурацию SynthID-Text через стандартный SynthIDTextWatermarkLogitsProcessor от Hugging Face. Она подавала вредоносные запросы шести моделям с открытым весом и сравнивала ответы при использовании водяных знаков и без них. Эксперимент показал, что водяные знаки изменяли ответы на вредоносные запросы, особенно когда они были сделаны с использованием техник внедрения запросов (prompt injection).
«Водяные знаки изменяют поведение отказа при прямых вредоносных запросах, но эффект более выражен, когда те же запросы сочетаются с техникой внедрения запросов», — написала Сипосова. «На нескольких моделях водяные знаки делают модель более склонной отвечать на вредоносные запросы, которые в противном случае она бы отклонила».
Эти изменения имеют важные последствия для безопасности, поскольку они влияют не только на ответы LLM, но и на последующие действия ИИ-агентов, полагающихся на модель.
«На уровне модели это может изменить поведение в области безопасности, включая то, отклонит ли модель вредоносный запрос и сохранится ли этот отказ при внедрении запросов», — написала исследователь. «На уровне агента те же выбранные токены могут определять, какой инструмент вызывается и какие аргументы ему передаются. Внедрение запросов связывает эти две настройки, поскольку ослабленный отказ становится более значимым, когда модель также может действовать через инструменты. Таким образом, такая процедура маркировки может повлиять как на то, что говорит модель, так и на то, что делает агент. Мы называем этот поведенческий эффект дрейфом выборки (sampling drift)».
Также интересно: Поведение ответов модели различалось в зависимости от используемого секретного ключа.


Существуют ограничения у данного исследования. Оно не тестирует, как изменяются ответы моделей Claude при маркировке. Вместо этого оно тестирует полдюжины моделей с открытым весом, поэтому у исследователя есть доступ к выборке токенов, которую можно было включать и отключать во время выборки в формате турнира, сохраняя остальные настройки неизменными. Эксперименты также тестировали реализацию выборки в формате турнира SynthID-Text в Hugging Face, а не конкретную реализацию, которую будут использовать модели Claude.
Тем не менее, результаты показывают, что по крайней мере некоторые формы подхода к маркировке могут влиять на безопасность моделей и агентов. Для упражнений по тестированию на проникновение (red-team) будет важно проводить стресс-тестирование своих платформ, чтобы убедиться, что они работают должным образом при развертывании SynthID.
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Dan Goodin