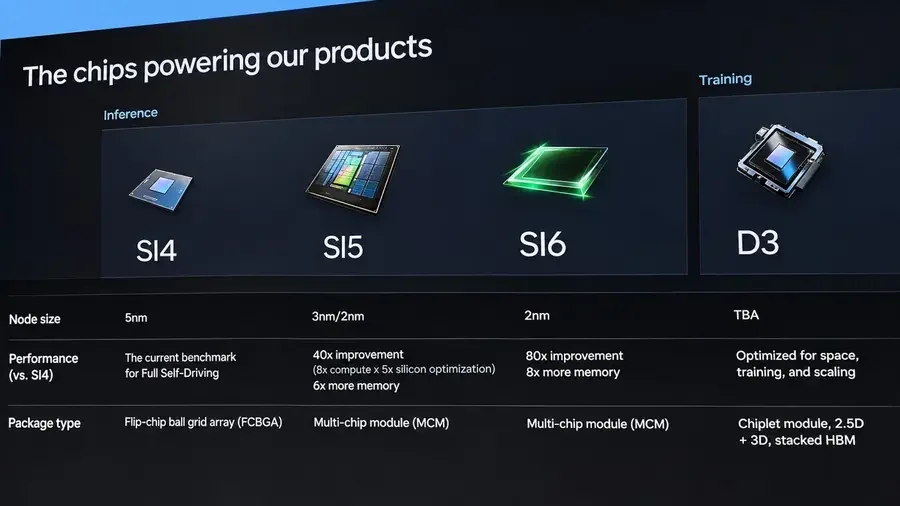
Tesla раскрыла обновленную дорожную карту своих ИИ-ускорителей, проливая свет на будущее разработок чипов компании. Компания Илона Маска ожидает, что ее ускоритель вывода 6-го поколения обеспечит в 80 раз большую вычислительную производительность по сравнению с существующим чипом 4-го поколения, в то время как ее обучающий ускоритель D3 откажется от архитектуры, ориентированной на SRAM, в пользу многочиповой конструкции со стековой памятью HBM. Кроме того, Tesla приняла термин “суперинтеллект” вместо “искусственного интеллекта” для своих ИИ-ускорителей, переименовав их в SI. Маск недавно подтвердил, что SpaceXAI будет переименована в SpaceXSI по той же причине.
“Подождите минутку… Я думал, чипы Tesla Илона Маска назывались AI4, AI5 и AI6. Но в этой последней презентации они теперь обозначены как SI4, SI5 и SI6. Затем я вспомнил: президент Трамп хочет заменить “Искусственный интеллект” (AI) на “Суперинтеллект” (SI). Похоже, Илон Маск уже принимает новую терминологию. 🤔 4 ноября 2026 г.”
Пожалуй, самым интересным событием в дорожной карте аппаратного обеспечения Tesla является возрождение собственного обучающего ускорителя Dojo после того, как Илон Маск отменил весь проект Dojo на уровне пластин в августе 2025 года, а затем заявил, что SpaceX и xAI будут использовать исключительно оборудование Nvidia в августе 2026 года, как в наземных, так и в внеземных центрах обработки данных. Тем не менее, Dojo 3-го поколения будет значительно отличаться от первых двух поколений, Dojo D1 и Dojo D2.
Tesla описывает свой обучающий ускоритель нового поколения Dojo 3 (D3) как чиплетную конструкцию, сочетающую технологии 2,5D и 3D-упаковки со стековой памятью HBM. Это представляет собой существенный отход от оригинальной архитектуры системы на пластине Dojo D1, которая полагалась на распределенную внутричиповую SRAM и 25 процессоров D1 с 11 ГБ SRAM, соединенных с помощью технологии упаковки масштаба пластины. Использование HBM предполагает, что Tesla намерена существенно увеличить емкость памяти, поскольку современные ИИ-модели потребляют огромное количество памяти для хранения параметров, активаций и промежуточных данных, что делает SRAM непривлекательной с точки зрения емкости. Использование HBM упрощает масштабирование памяти, но вносит различные компромиссы в отношении задержки, пропускной способности, упаковки и энергопотребления. Тем не менее, остается неясным, отказалась ли компания полностью от интеграции масштаба пластины.
С одной стороны, можно укладывать пользовательские модули HBM поверх логических кристаллов, соединенных с помощью технологии упаковки масштаба пластины. С другой стороны, интеграция на уровне пластин является дорогостоящей и имеет смысл только для определенных случаев использования, к которым относятся архитектуры, ориентированные на SRAM. Укладка HBM поверх логических кристаллов, соединенных в масштабе пластины, добавляет сложности проектирования, проблемы с охлаждением, сложность производства (т.е. потенциальное снижение выхода годных), проблемы долгосрочной надежности и, в конечном итоге, затраты. Хотя большинство проблем можно решить путем добавления избыточности и совершенствования технологических процессов, все это требует затрат, что делает масштабирование пластин менее вероятным для D3.
Tesla еще не раскрыла вычислительную производительность D3, емкость памяти, производственный процесс или график разработки. В то же время компания заявляет, что ее Dojo D3 будет оптимизирован для “космоса, обучения и масштабирования”, что означает, что устройство будет предлагать достойную производительность и будет легко масштабироваться (что опять же указывает на более традиционную архитектуру ускорителей, а не на упаковку масштаба пластины). Более интригующим является то, что D3 также будет оптимизирован для внеземных развертываний, что, вероятно, означает радиационную стойкость, по крайней мере, для определенных SKU.
Еще одна интересная деталь в дорожной карте — раскрытие приблизительной вычислительной производительности ускорителя вывода 6-го поколения Tesla (SI6): улучшение производительности в 80 раз по сравнению с HW4 и в 9 раз больше памяти по сравнению с HW4. В зависимости от того, как измеряется производительность HW4 (читайте далее для объяснения), речь идет о 17 280–46 080 TOPS (триллионов операций в секунду) или 17,28–46,08 POPS (квадриллионов операций в секунду), хотя мы ничего не знаем о поддерживаемых SI6 форматах данных. Конечно, это оценки, поэтому относитесь к ним с долей скептициса. Чтобы понять цифры в контексте, GPU Nvidia Rubin предлагает 50 PFLOPS для вывода, 35 PFLOPS для обучения и 17,5 FP8/FP6 PFLOPS. Тем временем Rubin уже поставляется клиентам, а SI6 ожидается в 2029–2030 годах. Есть дополнительные сведения о SI6, которые мы обсудим ниже.
Существующий процессор вывода 4-го поколения Tesla, используемый сегодня в автомобилях компании (который изначально назывался HW4, затем был переименован в AI4, а затем в SI4), производится Samsung Foundry с использованием 7-нм техпроцесса и полагается на традиционную упаковку flip-chip ball grid array (FCBGA) (обратите внимание, что предполагаемый слайд Tesla содержит ошибку и утверждает, что устройство изготовлено по 5-нм узлу), а также, предположительно, 16 ГБ памяти GDDR6. Компания описывает процессор как текущий эталон для своей технологии Full Self-Driving (FSD), что делает его базовым уровнем, по которому измеряется производительность будущих поколений. Тем временем Tesla официально не раскрывает абсолютные показатели вычислительной производительности чипа, емкость памяти или энергопотребление, что затрудняет сравнение. Илон Маск однажды сказал, что HW4 в 3–8 раз мощнее HW3, который официально оценивался в 72 TOPS, что делает HW4 ASIC мощностью 216–576 TOPS (обратите внимание, что это оценки).
Как и ожидалось, слайд подтверждает, что предстоящий ускоритель вывода 5-го поколения под названием SI5 (он же HW5, он же AI5) будет производиться с использованием 3-нм и 2-нм техпроцессов на TSMC и Samsung Foundry соответственно, и будет использовать многочиповый модуль (MCM), что является отходом от традиционного подхода к упаковке, используемого для HW4. Tesla ожидает, что SI5 обеспечит 40-кратное увеличение производительности по сравнению с HW4, что будет результатом восьмикратного увеличения вычислительных возможностей (обусловленного значительно более плотными техпроцессами и большим количеством исполнительных блоков) и пятикратного прироста за счет оптимизации кремния, по словам Илона Маска, что указывает на 8 640–23 040 TOPS (оценочная цифра), в зависимости от того, как считать производительность HW4. Тем временем ожидается, что процессор будет потреблять от 250 Вт до 800 Вт в зависимости от приложения, поэтому оценка производительности на данном этапе не является хорошим бизнесом. Между тем, процессор также будет иметь в шесть раз больше памяти, чем его предшественник (т.е. 96 ГБ). В зависимости от используемого типа памяти (GDDR6 или GDDR7), Tesla SI5 может обеспечить пропускную способность памяти от 768 ГБ/с до 1,536 ГБ/с.
Переходя к ускорителю вывода 6-го поколения Tesla (SI6), который призван еще больше увеличить вычислительную производительность до 80 раз по сравнению с HW4 и иметь в восемь раз больше памяти, чем процессор текущего поколения. Это может привести к 17,28–46,08 POPS (квадриллионов операций в секунду), в зависимости от того, как считать производительность HW4, и 144 ГБ памяти, что является значительной производительностью и объемом памяти для ИИ-ускорителя.
Tesla уже заключила соглашение с Samsung Foundry на производство своих ускорителей вывода 6-го поколения до 2033 года, и новый слайд показывает, что устройство будет изготовлено с использованием 2-нм техпроцесса. Учитывая, что чип ожидается в 2029–2030 годах, и недавно обновленную дорожную карту Samsung, мы, вероятно, говорим об автомобильном классе SF2A, улучшенном по производительности SF2P или даже SF2Z с подачей питания с обратной стороны. Между тем, бросается в глаза то, что Tesla не предполагает производство чипа на Terafab с использованием производственного процесса Intel 14A в 2030-х годах.
SI6 сохранит подход многочипового модуля (MCM), представленный с AI5/SI5/HW5, что кажется разумным, поскольку он позволит использовать опыт, полученный с ускорителем вывода 5-го поколения, и сохранить относительно разумные затраты на упаковку. Многие автопроизводители рассматривают возможность использования многочиплетных конструкций и памяти HBM для своих систем-в-пакете (SiP) нового поколения, что приведет к увеличению их затрат. Еще предстоит увидеть, когда Tesla начнет использовать HBM для своих ускорителей вывода, но, вероятно, не с SI6.
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Anton Shilov