
В течение многих лет Microsoft и OpenAI боролись за то, чтобы сохранить определенную информацию в тайне в своей борьбе с новостными организациями, которые обвиняли ИИ-компании в сговоре с целью нарушения авторских прав путем кражи огромного количества новостного контента для обучения ИИ.
Однако теперь детали, которые никогда не должны были быть помечены как конфиденциальные, начинают просачиваться. В ходатайстве о вынесении заочного решения, которое было рассекречено в четверг по иску новостных изданий во главе с The New York Times, представлены внутренние документы, которые, по утверждению новостных групп, точно показывают, как Microsoft и OpenAI оценивали угрозу для новостных изданий перед выпуском новых ИИ-продуктов, таких как ChatGPT и Copilot.
Возможно, самым взрывным заявлением стало то, что директор Microsoft по прикладным наукам Брент Хехт неоднократно предупреждал в документах, что сбор новостей для обучения ИИ является «удивительной кражей беспрецедентных масштабов», называя это, возможно, «крупнейшей кражей труда в истории человечества», как утверждают новостные организации. В другом документе Хехт опроверг аргументы Microsoft и OpenAI о том, что обучение ИИ на новостном контенте является добросовестным использованием, предположив, что план широкомасштабного сбора новостей «полностью высмеивает идею «добросовестного использования»».
В OpenAI глава ChatGPT Ник Тарли написал во внутреннем сообщении, что издатели столкнутся с «экзистенциальной угрозой» со стороны коммерческих продуктов, обученных на новостном контенте, которые могут использоваться для замены новостных поставщиков. Один документ Microsoft даже описывал «петлю гибели», как утверждают новостные организации, «которая одновременно навредит производительности наших моделей и всему Интернету».
«Крайне необычно, когда конечный продукт угрожает экономическим основам своих основных поставщиков, но именно такую ситуацию мы создали для нашего LLM-бизнеса в отношении его «цепочки поставок контента»», — говорится в этом документе.
,
Данные обеих компаний показывают, что этот прогноз оказался точным. Microsoft зафиксировала падение кликабельности на 83–93 процента для одних новостных истцов и на 51–94 процента для других. К этому добавились сообщения о низкой кликабельности результатов поиска ChatGPT и собственные сообщения новостных организаций о снижении трафика. Внезапно становится легче понять, как снижение доходов от новостей может в конечном итоге лишить чат-ботов обильных потоков надежной информации, которые якобы делают их такими новаторскими инструментами.
Тем временем, «почти никто не предполагал, что созданный им контент будет использоваться таким образом, и никто не получает за это компенсации», — признал Хехт в документе Microsoft.
Новостные организации заявляют, что они готовы к судебному разбирательству, поскольку существует так много «убедительных доказательств подмены». Если им удастся доказать, что чат-боты заменяют их на их собственных рынках, одновременно выдавая выдержки из статей дословно, они считают, что этот двойной удар может уничтожить аргументы Microsoft и OpenAI о добросовестном использовании.
«Будущее не только журналистики, но и ответственного ИИ зависит от сохранения стимулов для людей создавать творческие работы, от которых зависит здоровое общество», — утверждают новостные группы.
Чат-боты «в значительной степени подменяют, и точка»
Под присягой генеральный директор Microsoft Сатья Наделла свидетельствовал, что ИИ-компании не должны нарушать условия использования новостных сайтов, обходя платные стены. Но в OpenAI внутренние сообщения показали, что когда сотрудник Ник Райдер сообщил президенту Грегу Брокману, что был найден «хак» для обхода платного доступа NYT для краулеров OpenAI, Брокман ответил: «Ах, хорошо».
Наделла также признал, что чат-боты служили заменой новостным платформам, описывая, как чат-бот крадет клики у новостных сайтов, «предоставляя вам информацию прямо на сайте ИИ-платформы вместо необходимости переходить к исходному источнику».
,
Существует консенсус по этому поводу и в OpenAI, где инженер-программист заявил во внутреннем сообщении, что «независимо от того, насколько заметно мы показываем ссылки, пользователи не будут кликать».
Глава OpenAI Тарли согласился, что «нет причин кликать», когда чат-бот предоставляет информацию, говорится в ходатайстве. Он также, по-видимому, предположил, что петля гибели уже началась, описывая чат-боты как «в значительной степени подменяющие, и точка» и предсказывая, что они «будут становиться все более и более подменяющими по мере совершенствования».
Новостные группы утверждали, что собственные заявления инсайдеров должны быть уликой.
«В отношении результатов, которые существенно схожи с источниками обучения или заземления, суды отклоняли утверждения о том, что копирование новостных статей для предоставления продукта, подменяющего спрос на новости, является добросовестным использованием», — утверждали новостные группы.
Microsoft отрицает комментарии исполнительного директора
Новостные группы использовали множество различных тактик, чтобы проверить, будут ли продукты Microsoft и OpenAI выводить их новостные статьи дословно. Их ходатайство показывает, что они пошли дальше ранних стратегий, когда они просили чат-ботов предоставить доступ к полным новостным историям, многократно задавая вопрос «какая следующая строка?»
В некоторых случаях новостные организации обнаружили, что чат-боты генерируют длинные выдержки из статей, когда пользователи запрашивали краткое изложение статей. Другие отмеченные результаты были получены путем запроса ключевых тезисов статей. Особенно успешными были запросы, в которых чат-ботам предлагалось «оценить предвзятость» новостных статей. Чат-боты также воспроизводили части статей, если пользователи просили их выбрать любую статью с домашней страницы определенного сайта.
В своем ходатайстве новостные истцы просили суд вынести решение только по нарушенным статьям, где результаты «демонстрируют обширное дословное совпадение», поскольку они уверены, что «подменяющие цели копирования ответчиками перевешивают добросовестное использование». Юридические вопросы, связанные с другими статьями, будут подняты на суде, заявили они.
,
OpenAI не сразу ответила на запрос Ars о комментарии.
Однако представитель Microsoft защитил ИИ-продукты Microsoft как трансформационное добросовестное использование, которое не заменяет новостные сайты. Представитель заявил, что показания Наделла касались «общих принципов и изменений, происходящих в том, как люди находят и потребляют информацию», которые были просто «наблюдениями», которые «не следует путать с выводами о вопросах авторского права, находящихся на рассмотрении суда, которые Microsoft рассматривает в своих документах».
Относительно комментариев Хехта представитель заявил, что эти документы «отражают лишь индивидуальную точку зрения одного сотрудника, не являются юридическим анализом и не представляют взгляды компании».
Стивен Либерман, юрисконсульт New York Daily News и семи ее сестринских газет, не согласен. Он сказал Ars, что «представленные здесь впервые доказательства показывают, что OpenAI и Microsoft знали, что они делают, было неправильным».
«На протяжении всего этого дела ответчики настаивали на том, чтобы эти документы считались конфиденциальными, чтобы общественность не могла их видеть», — сказал Либерман. «Ну, теперь все тайное стало явным. Наконец, мир может увидеть, что OpenAI и Microsoft думали все это время о справедливости своего поведения».
Исполнительный директор Microsoft описал «случайное сокрытие»
Новостные истцы утверждали, что независимо от того, кто выражал эти взгляды, внутренние документы ясно дают понять, что фирмы предвидели, что дословные результаты нанесут ущерб новостным сайтам. Кроме того, они утверждали, что вместо того, чтобы предотвращать такие результаты, фирмы пытались затруднить новостным группам тестирование чат-ботов, создав фильтр, который, по мнению Хехта, мог быть воспринят как «случайное сокрытие», поскольку он привел бы к тому, что «люди, имеющие права на контент, будут иметь меньшее представление о том, что использовалось для обучения».
,
Новостные группы также возмущены тем, что вместо того, чтобы прислушиваться к инсайдерам, предупреждавшим, что сбор новостей является кражей, Microsoft и OpenAI так и не решили лицензировать контент, якобы узурпировав их на другом рынке способами, которые они не могли предвидеть.
В частности, их ходатайство обвинило Microsoft в нарушении «отраслевых норм» путем продажи набора данных, приобретенного для Bing, в качестве обучающих данных для OpenAI, якобы сделав это без консультации с новостными группами, которые не одобрили бы такое перепрофилирование их согласия на базовый краулинг поисковых систем. Кроме того, OpenAI якобы «действовала ненадлежащим образом», получив набор данных NYT из 1,8 миллиона статей от третьей стороны, которая была связана соглашением о том, что данные не будут использоваться в коммерческих целях. Сотрудники OpenAI знали, что «было бы неуместно» использовать эти данные «для обучения модели», но они все равно это сделали, утверждают новостные группы.
Для новостных групп проблема заключается не только в Microsoft и OpenAI, но и во всех ИИ-компаниях, которые следуют их примеру, «бесплатно пользуясь» их контентом, говорится в ходатайстве. Наиболее заметно, что после запуска ChatGPT, Google AI Overviews был быстро представлен и начал поглощать еще больше трафика, который ранее шел на новостные сайты.
Если суды не разъяснят, что ИИ-компании должны лицензировать новостной контент, то и новостные издатели, и ИИ-компании могут быть обречены, утверждают новостные истцы. Один внутренний документ Microsoft согласился с тем, что существует «реальный риск того, что GenAI может «существенно нарушить» «занятость тех самых людей, которые создали данные, на которых обучалась базовая модель»», — отметили они. Microsoft даже включила мультфильм, иллюстрирующий проблему LLM, разрушающих их собственные цепочки поставок:
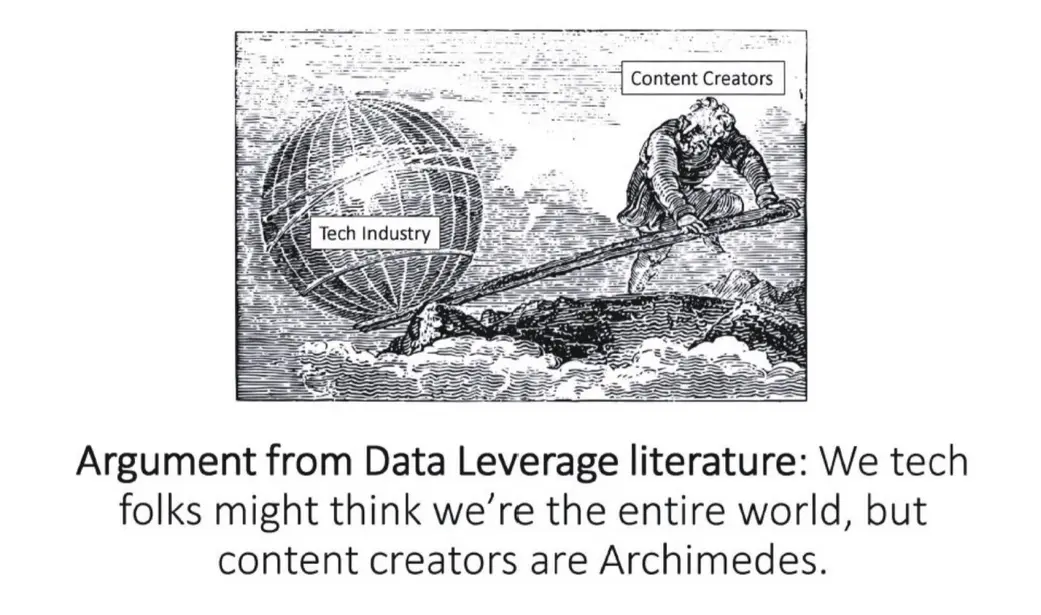
«ИИ-компании остаются бессильными вырваться из этой «петли гибели», потому что, хотя вся отрасль выиграла бы, если бы каждая компания платила за поддержание непрерывного производства творческих работ, от которых зависит их технология, каждой отдельной компании выгоднее брать контент бесплатно, пока другие платят», — утверждают новостные группы.
В качестве доказательства этой слепой жадности их ходатайство подчеркнуло, что Брокман написал, что он «глубоко мотивирован триллионами», которые можно получить от коммерциализации технологии OpenAI.
«Признание того, что копирование новостей для ИИ не является добросовестным использованием, решит эту дилемму заключенного, поставив все ИИ-компании, включая OpenAI и Microsoft, на равные условия», — заявили новостные организации.
Эта история была обновлена цитатой юрисконсульта New York Daily News Стивена Либермана.
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Ashley Belanger


