
Для запуска LLM объемом 120 млрд параметров, такой как gpt-oss-120b, с приемлемой производительностью требуется минимум от 60 до 80 ГБ видеопамяти (VRAM) и системной памяти. Это означает, что для достижения такого результата абсолютно необходимо дорогостоящее оборудование. Однако один амбициозный пользователь сумел справиться с этой задачей, объединив несколько бюджетных машин и смартфон на Android, продемонстрировав, что даже с ограниченным бюджетом нет предела человеческой изобретательности.
Несмотря на достижение невозможного, кластер устройств, работающих с 120B LLM, будет демонстрировать невероятно низкую скорость, что делает этот эксперимент непрактичным
Реддитор под ником “Medicine_Blogscanner”, используя Galaxy S24+, мини-ПК с RTX 3060 и 12 ГБ видеопамяти, ноутбук Windows с скромными 12 ГБ оперативной памяти, а также комбинацию MacBook Pro на базе Intel, Mac mini и MacBook Pro M3, успешно запустил 4-битную квантованную версию gpt-oss-120b, для работы которой требуется минимум 60 ГБ памяти. Если вы задумаетесь о запуске той же LLM без квантования, вам понадобится 240 ГБ ОЗУ, что делает эту задачу невыполнимой для большинства владельцев оборудования.
Для реализации этого на обычных потребительских устройствах были применены два подхода. Общий объем памяти был сокращен до 47 ГБ, а программное обеспечение, объединившее шесть устройств, использовало технику конвейерного параллелизма. Как видно на изображении ниже, вместо того чтобы заставлять один компьютер загружать всю модель, «мозг» ИИ был разделен по слоям между всеми устройствами в сети.
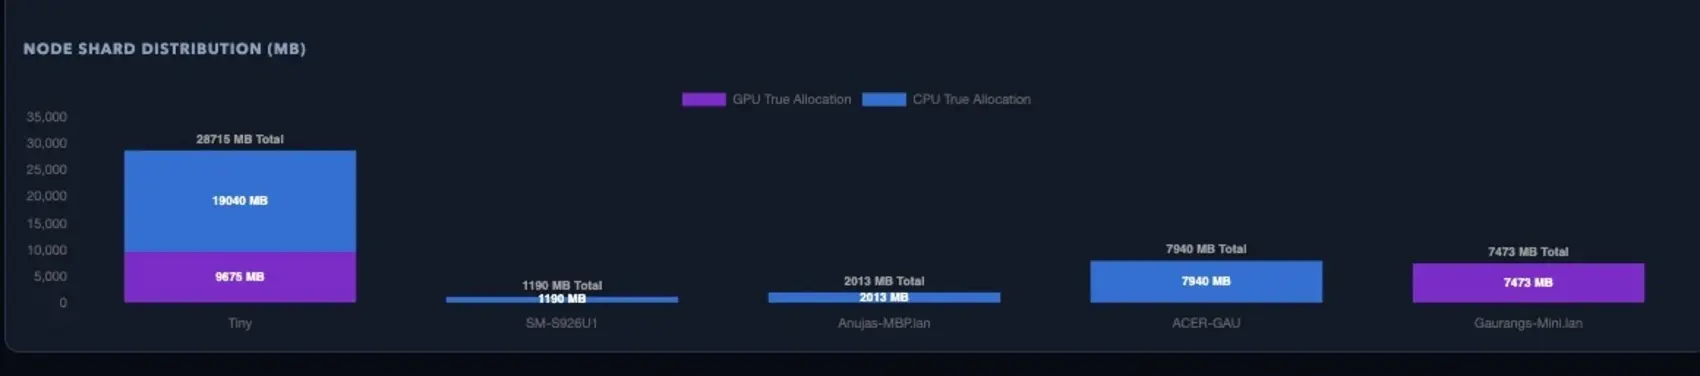
Рабочая нагрузка была распределена, причем основное устройство под названием “Tiny” выполняло большую часть работы, предоставляя около 28,7 ГБ общей системной памяти и RTX 3060. В настоящее время запускать такие ИИ-модели, как gpt-oss-120b, возможно только с 128 ГБ унифицированной памяти, которая доступна лишь в чрезвычайно дорогих машинах, таких как топовые модели MacBook Pro или готовящиеся к выпуску ноутбуки RTX Spark.
Тот факт, что различные машины с меньшим объемом памяти могут запускать гораздо более плотные LLM, дает надежду многим пользователям на запуск аналогичных моделей, хотя и с существенным компромиссом в производительности. Хотя 120B ИИ-модели можно запустить на этом кластере со скоростью всего 1,1 токена в секунду, это определенно непрактичный подход, если вы действительно хотите повысить свою продуктивность без активного подключения к интернету.
Если вы достаточно терпеливы, чтобы запускать эту модель и испытывать работу с длинными текстами на невероятно медленной скорости, тогда мы можем рекомендовать вам этот путь. Если же вы не настолько смелы, лучше выбрать менее плотные модели.
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Omar Sohail


