
MLPerf v6.1 вышел, AMD, NVIDIA и Intel представили свои последние результаты в ряде тестов производительности ИИ.
AMD и NVIDIA демонстрируют высокую производительность в области ИИ в MLPerf 6.1, Intel также представляет Xeon и Arc Pro в бенчмарках
Последний выпуск от MLCommons представляет собой набор тестов MLPerf Inference v6.1, который включает ряд рабочих процессов, соответствующих последним тенденциям в сегменте ИИ. Как всегда, все три лагеря представляют результаты своего текущего и новейшего оборудования, и мы собрали тесты в следующих таблицах.
Начиная с DeepSeek R1, AMD представляет свою самую крупную конфигурацию кластера, включающую 512 графических процессоров Instinct MI355X. Это обеспечивает лидирующую производительность как в автономных, так и в серверных сценариях использования. GB300 и GB200 от NVIDIA тестировались в конфигурациях с 288 графическими процессорами, и конфигурация GB300 оказалась близка к платформе MI355X.
Здесь мы также видим первое применение NVIDIA Vera Rubin (VR200) в конфигурациях с 72 и 36 графическими процессорами. Конфигурация с 72 графическими процессорами до 95% быстрее, чем конфигурация GB300 с 72 графическими процессорами, в то время как конфигурация с 36 графическими процессорами быстрее, чем конфигурация GB200 с 72 графическими процессорами, что весьма впечатляет. Это предварительный просмотр, и мы увидим еще больше результатов для Vera Rubin по мере ее развертывания и тестирования в наборе MLPerf.
Для GPT-OSS 120B AMD снова протестировала свою самую крупную конфигурацию с 512 графическими процессорами, которая лидировала в автономных и серверных сценариях.
Кроме того, конфигурация NVIDIA GB300 “Grace Blackwell Ultra” лидировала в сегментах с 72 и 8 графическими процессорами. MI350P от AMD также оказался быстрее, чем MI300X, как в конфигурациях с 8 графическими процессорами. Intel также продемонстрировала свои возможности в наборе тестов с Arc Pro B70, в то время как RTX PRO GPU от NVIDIA также тестировались в конфигурациях с 8 и 4 графическими процессорами.
В Llama2 70B графические процессоры Blackwell от NVIDIA доминируют в конфигурациях с 72 графическими процессорами. NVIDIA GB300 также превзошел MI355X от AMD в конфигурациях с 8 графическими процессорами, но платформа Instinct оказалась быстрее решения GB200 Blackwell. Опять же, MI350P от AMD, RTX PRO от NVIDIA и Arc Pro от Intel показали хорошие результаты. Приятно видеть, что результаты MLPerf представляются на рабочих станциях.
Наконец, у нас Llama 3.1-8B, где конфигурация NVIDIA GB300 (8-GPU) была до 17% быстрее, чем AMD MI355X (конфигурация с 8-GPU). Остальные результаты можно увидеть ниже:
Конечно, все эти результаты великолепны, но все работают над оптимизацией своего новейшего и лучшего оборудования для предстоящих тенденций в области ИИ. Именно поэтому результаты, которые вы видите сегодня, через несколько месяцев будут другими. Постоянные оптимизации на уровне программного стека и аппаратного обеспечения не только повышают производительность, но и способствуют эффективности, что означает лучшую пропускную способность и больше возможностей для масштабирования платформ.
Ниже приведены основные моменты от каждого производителя относительно их соответствующих представлений MLPerf 6.1 сегодня:
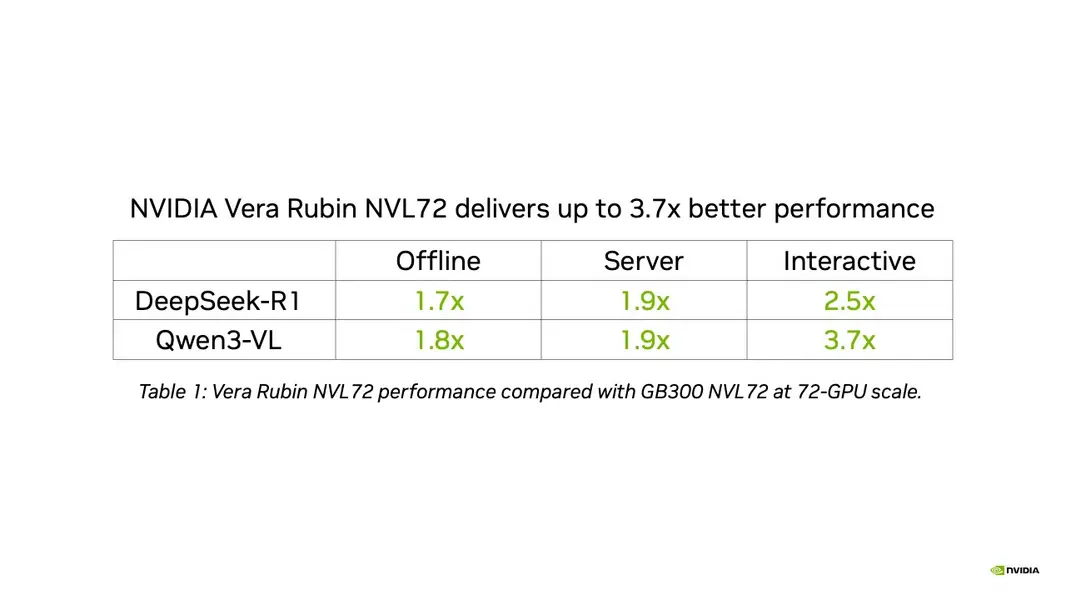
- Система NVIDIA Vera Rubin NVL72 дебютирует с лидирующей производительностью: В своем первом предварительном представлении MLPerf Inference NVIDIA Vera Rubin NVL72 обеспечивает до 3,7 раз лучшую пропускную способность, чем GB300 NVL72.
- NVIDIA GB300 NVL72 масштабируется с ведущей эффективностью: Представление 288 графических процессоров в четырех стойках GB300 NVL72 достигло 99% эффективности масштабирования, при этом пропускная способность росла почти линейно от базовой конфигурации одной стойки.
- Непрерывные программные оптимизации обеспечивают прирост производительности: Программные оптимизации в представлениях NVIDIA MLPerf Inference v6.1 обеспечили до 1,6 раз более высокую производительность по сравнению с v6.0. Оптимизации продолжались и после представления v6.1, обеспечивая дальнейший прирост производительности.
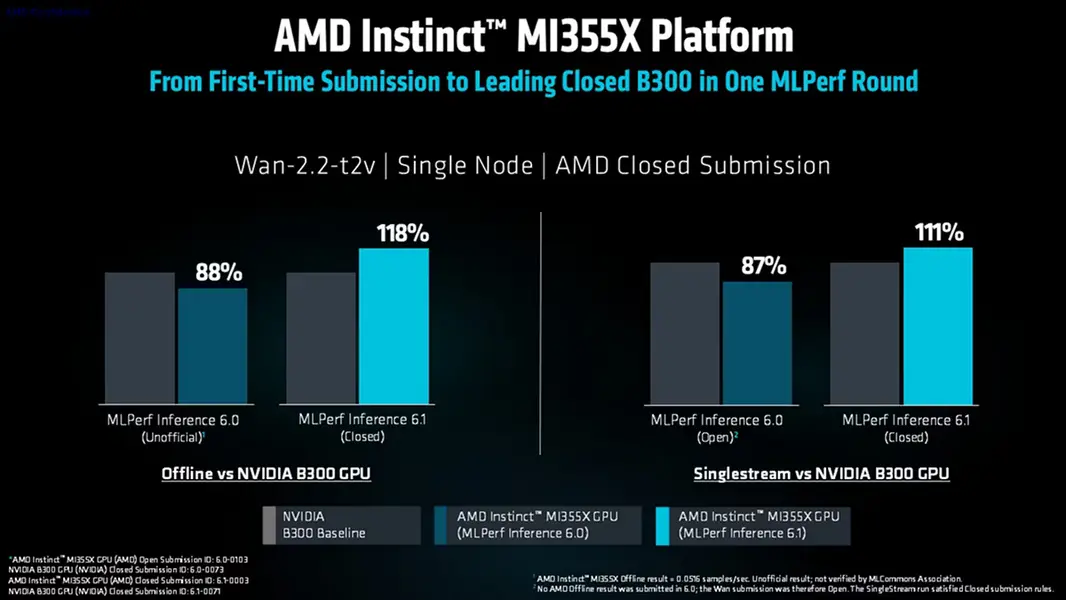
- Больше производительности от того же аппаратного обеспечения AMD Instinct MI355X GPU: В течение одного цикла MLPerf непрерывные программные оптимизации AMD ROCm увеличили пропускную способность GPT-OSS-120B на 8 GPU, снизили задержку Wan-2.2 и повысили пропускную способность кластера с меньшим количеством GPU.
- Лидирующая производительность графических процессоров AMD Instinct MI355X и MI350P: Графические процессоры AMD Instinct MI355X превзошли результаты NVIDIA B200 и B300 GPT-OSS-120B при 8 GPU и результат NVIDIA GB200 при 72 GPU. В своем первом раунде MLPerf графические процессоры AMD Instinct MI350P превзошли выбранные результаты NVIDIA RTX PRO 6000 Server Edition и H200 NVL.
- Рекордная пропускная способность токенов и масштабирование инференса в производственном масштабе с эффективным масштабированием: При 72 GPU графический процессор AMD Instinct MI355X достиг 95% эффективности масштабирования на GPT-OSS-120B. Отдельно Crusoe достиг рекордной совокупной пропускной способности токенов при 512 GPU, достигнув 5,75 миллиона автономных токенов в секунду на GPT-OSS-120B и 2,90 миллиона на DeepSeek-R1.
- О результатах Intel Xeon 6: Intel расширила свое участие в Xeon в MLPerf v6.1 с двух протестированных SKU Xeon 6 в v6.0 до пяти, увеличив количество результатов инференса CPU с 24 до 35. Intel Xeon остается единственным автономным серверным CPU, представленным в результатах MLPerf Inference.
- О результатах Intel Arc Pro B70: Представления Intel Arc Pro B70 расширяют возможности программных улучшений для повышения производительности в ряде моделей ИИ. Один узел, сконфигурированный с четырьмя графическими процессорами Intel Arc Pro B70, обеспечивает 128 ГБ видеопамяти и поддерживает представления для Llama 3.1 8B, Llama 2 70B, gpt-oss-120B, Whisper и сквозной генерации с дополненным поиском (E2E-RAG). На той же четырехпроцессорной системе, используемой в v6.0, производительность gpt-oss-120B Server улучшилась на 36%, а автономная производительность увеличилась на 27%, что отражает продолжающуюся зрелость программного стека Intel.
MLPerf Inference v6.1 демонстрирует переполненное, быстро меняющееся поле, а не одного победителя. 512-процессорный кластер MI355X от AMD задал темп в экстремальном масштабе на DeepSeek R1 и GPT-OSS 120B, в то время как первый предварительный просмотр NVIDIA Vera Rubin уже выглядит как скачок: 72-процессорная система VR200 почти удвоила соответствующую стойку GB300, и даже установка с 36 процессорами превзошла стойку GB200 с 72 процессорами.
В более распространенных размерах 8 и 72 GPU картина смешанная — GB300 часто лидирует в Llama 2 70B и Llama 3.1 8B, AMD остается конкурентоспособной или опережает в некоторых запусках GPT-OSS, а MI350P плюс RTX PRO и Intel Arc Pro B70 доказывают, что аппаратное обеспечение рабочих станций теперь может быть в одном ряду. Intel также сохранила Xeon как единственный автономный CPU в наборе.
Настоящая история заключается в том, как быстро программное обеспечение продолжает двигать цифры. NVIDIA заявила о приросте до 1,6 раза благодаря работе стека с момента выхода v6.0; AMD улучшила тот же кремний MI355X в течение одного цикла; Intel повысила результаты Arc Pro на идентичном оборудовании. Эти результаты — снимки, а не потолки. По мере того как Rubin будет поставляться, ROCm и CUDA будут продолжать совершенствоваться, и появятся новые кластеры, следующий раунд MLPerf будет выглядеть иначе — и именно этого хочет индустрия.
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Hassan Mujtaba


