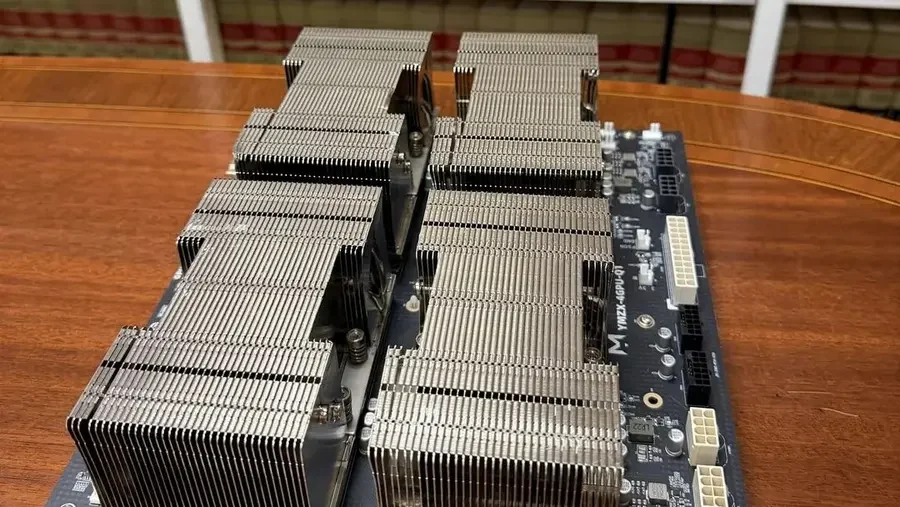
Юрист опубликовал в Reddit рассказ о своем частном ИИ-сервере, собранном из восьми бывших в употреблении дата-центровых GPU Nvidia Tesla V100 2018 года выпуска, чтобы файлы по делам никогда не покидали офис. С двумя платами SXM2 NVLink на четыре карты каждая, четырьмя коммутаторами PEX и повсеместно кабелями SlimSAS — плюс один сгоревший разъем питания — сборщик теперь запускает открытую модель DeepSeek V4.1 Flash со всеми экспертами в памяти GPU, со скоростью до 215 токенов в секунду. Платы на четыре GPU стоили около 2400 долларов каждая на момент покупки сборщиком.
Восемь карт Tesla V100-SXM2-32GB, каждая с 32 ГБ HBM2 при пропускной способности 900 ГБ/с, подключаются к SXM2, мезонинному разъему Nvidia для дата-центровых GPU, а не к слотам PCIe, и разделены между двумя базовыми платами. Внутри каждой платы все четыре карты объединены NVLink — прямой связью GPU-GPU от Nvidia — для получения 128 ГБ на плату, но две платы общаются только через PCIe. Каждая плата подключается к хосту через две карты-коммутатора PEX (PLX) с помощью кабелей SlimSAS, всего четыре коммутатора, каждый из которых обслуживает два GPU на скорости PCIe 3.0 x8 через собственный аплинковый канал x16.
Указанные цены уже в прошлом: бывшие в употреблении карты V100 SXM2 32GB теперь продаются на eBay примерно за 900 долларов, что более чем вдвое превышает примерно 400 долларов за штуку, указанные в посте, и предложения предполагают дальнейший рост цен. Система также уже имеет некоторые другие необходимые компоненты: материнскую плату Gigabyte Threadripper Pro с 12-ядерным процессором 3945WX, 8x 32 ГБ DDR4 RDIMM, один NUMA-узел и два блока питания общей мощностью 2800 Вт, подключенные к отдельным обычным офисным цепям. Это реальный пример использования бывших в употреблении дата-центровых аппаратных средств как дешевого способа объединить большой объем быстрой видеопамяти в одном месте.
Сервер в настоящее время используется ежедневно для первичной обработки файлов по делам: он читает папку с записями, извлекает факты, даты и цифры, обобщает их и выполняет первый этап рутинного составления документов. «Ничто не выходит из двери без реальной проверки», что является хорошей политикой человеческого контроля в целом. Это также помогает обеспечить конфиденциальность дел, когда файлы клиентов не могут быть отправлены в облачную или передовую модель. Интегрированы базы данных RAG и вызовы инструментов; оператор может управлять системой через интерфейс в стиле Discord по SSH, в данном случае с ПК под управлением Windows. Пока что он обрабатывает только один запрос за раз.
DeepSeek V4.1 Flash сжат в основном до 2 бит, а его веса по-прежнему составляют 248,8 ГБ. «Эксперты» модели, части, выполняющие большую часть работы для каждого слова, находятся полностью в памяти GPU, в то время как около 110 ГБ таблиц поиска, называемых таблицами Engram, остаются в обычной оперативной памяти системы. Извлечение из ОЗУ занимает около 0,12 миллисекунды на шаг, что, по словам сборщика, едва ли влияет на показатели скорости.
Первая половина слоев модели (0–19) работает на первой плате SXM2, а вторая половина (20–39) — на второй. Каждая плата обрабатывает свой интенсивный трафик через собственный NVLink, поэтому за шаг между платами проходит только один переход через более медленное соединение PCIe. В более раннем посте сборщик обнаружил, что разделение каждого слоя между всеми восемью картами привело к резкому падению скорости из-за этого перехода PCIe.
Производительность удивительно хороша для модели такого размера. Код генерируется быстрее всего, со скоростью до 215 токенов в секунду, поскольку небольшая черновая модель, встроенная в DeepSeek, угадывает пять токенов вперед, а код легко угадывается. Юридическое письмо, для которого предназначен сервер, выполняется со скоростью до 118 токенов в секунду.
Обработка длинных документов занимает больше времени: модель читает запросы со скоростью около 2200 токенов в секунду, поэтому при 128 тыс. токенов первый токен появляется примерно через минуту. Она может принимать до 524 тыс. токенов контекста. За три дня до публикации та же модель на четырех таких картах выдавала всего 36–38 токенов в секунду. Скачок произошел со второй платой, которая, предположительно, могла удвоить производительность в идеальных условиях, а остальное сборщик приписывает пользовательским ядрам и предварительной обработке. Полная разбивка приведена в таблице.
*Измерения сборщика, 5 ноября; жадное декодирование, 1024 токена на выходе, среднее из двух запусков.*
Это было не так просто, как подключить все и включить питание. Хост дважды перезагружался с фатальной ошибкой PCIe на линии к одной плате GPU, оба раза с более высоким пределом мощности и без ограничений тактовой частоты GPU. В этом состоянии карты потребляли 192–232 Вт, превышая предел в 180 Вт. Наиболее вероятное предположение, хотя и «не доказанное», заключается в том, что плата перестает отвечать во время пиковых нагрузок.
Перезагрузки прекратились после того, как сборщик ограничил тактовые частоты и удалил одну плату, у которой был след ожога на разъеме питания; «Проверяйте свои разъемы, люди». Каждая карта теперь ограничена 150 Вт, половиной от номинальных 300 Вт, а тактовая частота графики ограничена 1522 МГц. Согласно тестам, ограничение в 200 Вт не дало заметного прироста производительности.
Системная память также выдавала неисправленные ошибки ECC, которые исчезли после того, как сборщик снизил частоту ОЗУ с DDR4-3200 до DDR4-2666. Одна из видеокарт была подключена на скорости x4 вместо x8 при последней проверке, и сборщик планирует переустановить ее; один комментатор связал ту же проблему на своем V100 с неисправным кабелем.
Боль стоила того, поскольку примерно 50–60% существующих рабочих процессов юриста с использованием LLM теперь могут выполняться на этой машине вместо передовых моделей. Помогает сократить разрыв второй сервер DeepSeek на двух DGX Spark, где две системы передают работу друг другу. Установка действительно экономит деньги, по крайней мере, по сравнению с ценами API, хотя сборщик говорит, что она не намного быстрее. Однако она защитит данные клиента «после того, как они будут самодостаточными, что и является целью».
Сборщик добавил, что блок V100 может также получить цепь на 240 В. Помимо питания, система также работает на последней версии драйвера Nvidia R580, которая является последней для поддержки Volta. Пока что юрист признает, что это в основном хобби, но в будущем это может стать бизнес-идеей. Следующий шаг — обрабатывать два или три запроса одновременно, что было построено и проверено на тестовой системе, но еще не на сервере.
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Shane Downing