
Недавно Vulsar AI опубликовала тест Creative Writing, оценивающий производительность различных LLM по сравнению с начинающими и профессиональными авторами-людьми. В связи с распространением ИИ в различных отчетах упоминается, что профессии, связанные с написанием текстов, находятся под угрозой замены превосходящими моделями искусственного интеллекта. Однако новый тест, основанный на 475 запросах, показывает, что только передовые модели могут превзойти людей в этом отношении, причем только начинающих авторов, а не профессионалов.
GPT 6 Astra возглавляет «общий» рейтинг, немного превосходя начинающих авторов-людей
Тест, проведенный Vulsar AI, оценивает положение LLM при тестировании генерации текстов в длинном формате. В качестве основы использовалась модель вознаграждения, дообученная на данных о предпочтениях людей, для прогнозирования общего предпочтения читателей. Согласно рейтингам на приведенных ниже скриншотах, GPT 6 Astra лидирует с прогнозируемым показателем побед в 87,8%, опережая авторов-людей, которые получили 86,6% прогнозируемых побед. Опять же, разрыв в навыках между начинающими авторами-людьми и профессиональными авторами-людьми огромен.
Хотя тест показывает, что передовые модели, такие как GPT 6 Astra, смогли превзойти начинающих авторов, профессионалы по-прежнему демонстрируют заметно более высокие результаты при отдельной оценке. На третьем месте GPT 5.6 Sol от OpenAI с прогнозируемым показателем побед в 77,6%, а Claude Fable 5.1 от Anthropic — 70,3%. Однако наблюдается значительное падение результатов при переходе от многотриллионных моделей ИИ.
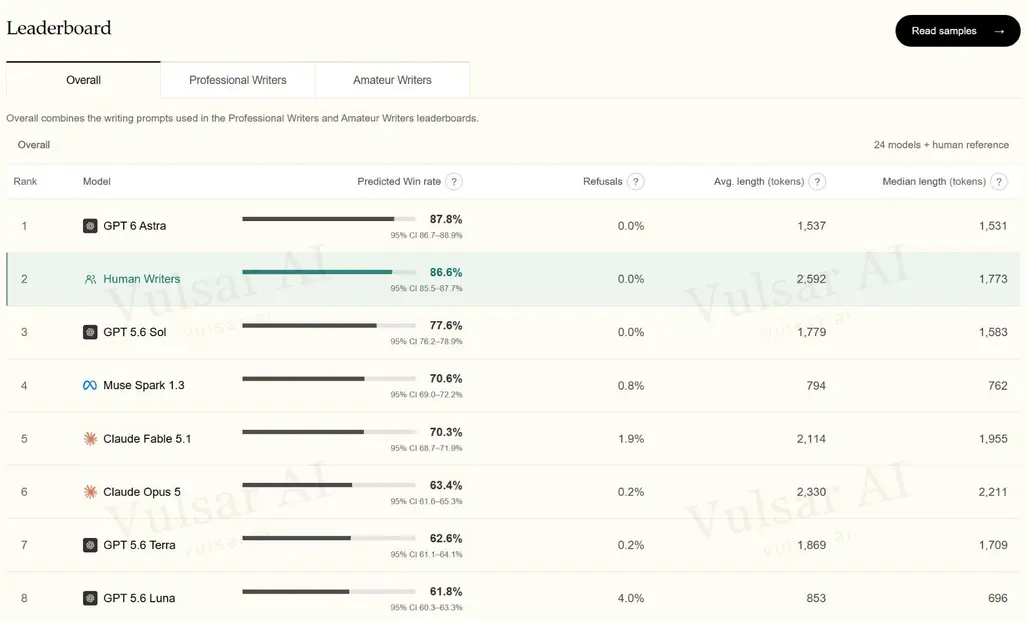
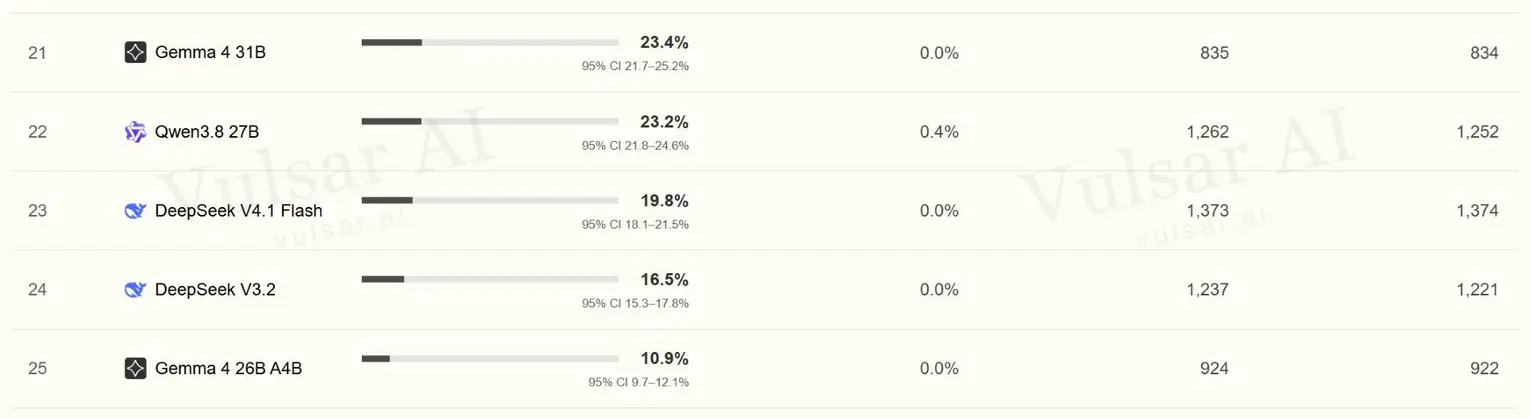
Например, Claude Opus 5, Kimi K3, Grok 4.6 и другие попали в диапазон 50–65%, что указывает на наличие ограничений у этих высокопрофильных моделей и у базовых человеческих показателей. Менее плотные модели дают еще худшие результаты: популярные LLM, такие как Qwen3.8-27B, достигают 23,2%, DeepSeek V4.1 Flash — 19,8%, а Gemma 4 26B находится на дне с результатом всего 10,9%.
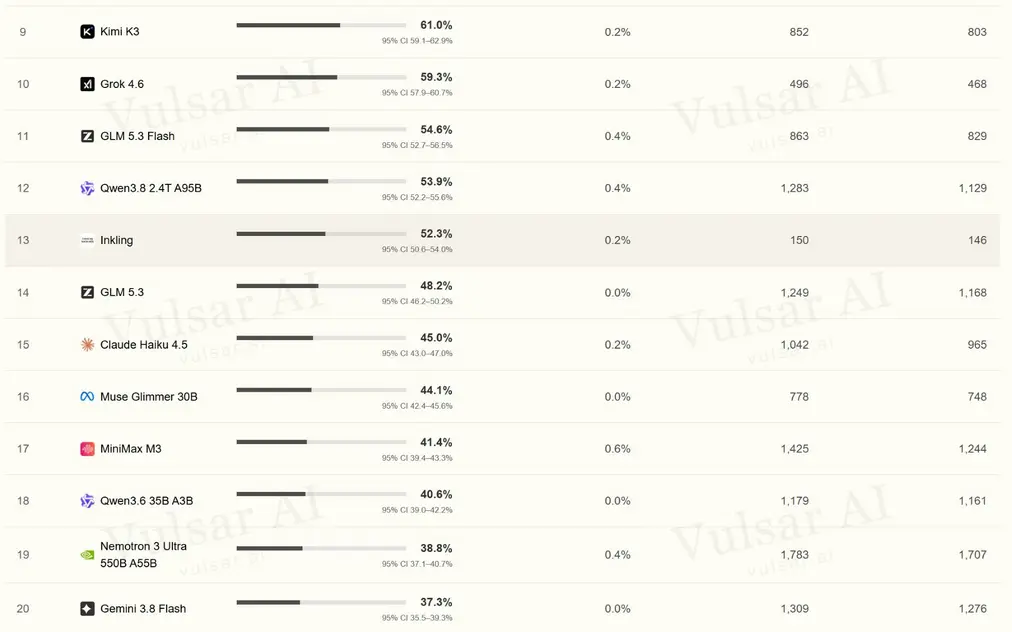
С точки зрения генерации токенов, авторы-люди выдали наибольший объем на запрос — 2592 токена, за ними следуют такие модели, как GPT 6 Astra (1537 токенов) и Claude Fable 5.1 (2114 токенов). Обсуждение на Reddit выявляет болезненное ограничение меньших моделей: они склонны терять связность при многоглавных запросах, выдавая повторяющиеся фразы, поэтому авторы-люди считаются в этом отношении превосходящими.
Авторы-люди не только способны поддерживать сложный сюжет, но и их спонтанное мышление позволяет им на лету менять стиль и производительность. Опять же, сколько времени пройдет, прежде чем мы столкнемся с LLM, которые смогут в значительной степени воспроизвести то, чего достигают профессиональные писатели? Это будет предмет для другого обсуждения.
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Omar Sohail


