
16 ГБ памяти GDDR6 и пропускная способность 448 ГБ/с у PS5 — неплохие характеристики для запуска локальной модели ИИ. Похоже, кто-то предпринял эту смелую попытку, хотя и с рядом компромиссов. Перенеся вычисления с центрального процессора на графический, один пользователь сумел освободить достаточно памяти и успешно запустил Qwen3.8-27B, большую языковую модель (LLM) с 27 миллиардами параметров.
Проект под названием «PS5LM» использовал центральный процессор в качестве полезной нагрузки, но ограничил доступную память всего 6 ГБ; оптимизированный порт увеличил объем ОЗУ до 11,4 ГБ
Для начала эксперимента пользователь Reddit u/metover представил неофициальный порт llama.cpp, который позволил PlayStation 5 запускать модели ИИ, используя центральный процессор в качестве полезной нагрузки. К сожалению, как выяснил другой пользователь Reddit под ником «u/AdIllustrious7246», такой подход сильно ограничивает доступную память всего 6 ГБ, что означает отсутствие кадрового буфера для запуска более объемных моделей ИИ.
В результате ему удалось портировать llama.cpp на PS5 как нативное приложение, используя Vulkan через порт RADV — это драйвер AMD с открытым исходным кодом из Mesa. Это изменение увеличило объем памяти с скромных 6 ГБ до 11,4 ГБ, предоставив достаточный запас для запуска сильно квантованной версии Qwen3.8-27B. При 16-битной точности потребовалось бы 54 ГБ памяти, что возможно только в системах с несколькими графическими процессорами или одним графическим процессором в сочетании с большим объемом системной ОЗУ.
Поскольку у PS5 нет таких конфигураций, на консоли была опробована версия Qwen3.8-27B-UD-IQ2_XXS, хранящая веса примерно по 2 бита каждый, что сократило размер до 6,8 ГБ, как показано на изображении панели управления. Естественно, главный компромисс при запуске сильно квантованной модели ИИ — это качество, что приводит к большему количеству ошибок и более слабому логическому выводу у Qwen3.8-27B. При контекстном окне 64K общее использование памяти составило 91 процент.
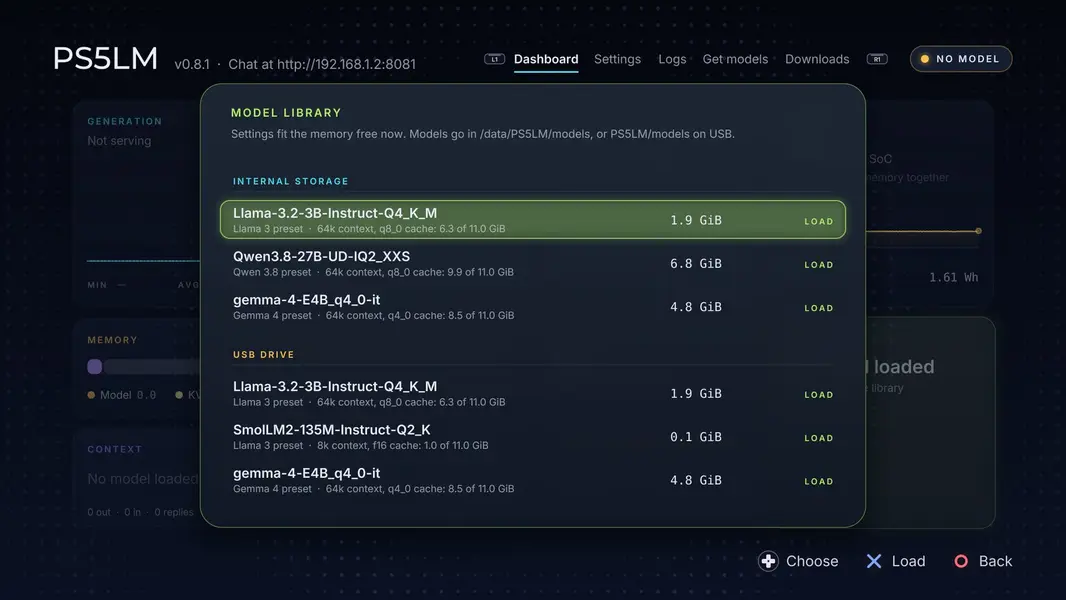
Благодаря неплохой пропускной способности памяти PS5, Qwen3.8-27B смог достичь скорости 20,9 токенов/с при 100% загрузке GPU и 2% загрузке CPU. Меньшие модели ИИ показали более высокую скорость генерации токенов: Gemma 4 E4B достигла 61 токена/с, а Llama 3.2 3B — 124 токена/с. Общее энергопотребление составило 86 Вт, при этом PS5 оставалась прохладной при 54°C. Хотя это впечатляющий результат для консоли, предназначенной только для игр, следует знать о нескольких компромиссах.
16 ГБ памяти ограничивают вас запуском сильно квантованной LLM на 27B или значительно меньших моделей ИИ, что означает, что вы можете не получить желаемого качества. Кроме того, для запуска нативного приложения llama.cpp на PS5 требуется джейлбрейк, который аннулирует гарантию и может привести к бану в онлайн-играх. Если вы считаете это впечатляющим, подождите, пока не узнаете о другом человеке, который запустил ИИ-модель на 120B, используя в общей сложности шесть устройств, включая Galaxy S24+.
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Omar Sohail


