
Использование ИИ-агентов в миллионах организаций открывает новые возможности для злоумышленников, позволяя им совершать вредоносные действия, такие как кража содержимого баз данных, конфиденциальной деловой и личной информации.
За последние пять месяцев Google и четыре другие организации, мало связанные между собой, кроме использования ИИ-агентов, сообщили об уязвимостях, которые позволяют злоумышленникам использовать одного агента в целевой сети для распространения вредоносных инструкций на других внутренних агентов. Эта техника представляет собой особую форму инъекции команд (prompt injection), нацеленную не на большую языковую модель (LLM), а на конкретного агента, например, для перевода или анализа данных. Системы защиты (guardrails) в таких агентах, если они вообще существуют, часто работают слабо и передают инструкции другим агентам по цепочке. Поскольку последующий агент полностью доверяет первому, он выполняет полученные указания.
Неожиданно и сложно устранить
Независимый исследователь Саид Анас Мохиуддин протестировал агенты таких организаций, как Google, JP Morgan Chase, Weviate, Rapid7, межведомственное цифровое управление правительства Франции и федеральное правительство США. Его демонстрационные атаки используют пробелы в доверии в MCP (Model Context Protocol) — протоколе контекста модели. Этот стандарт является одним из способов взаимодействия ИИ-приложений и агентов внутри внутренней сети. Иллюстрация ниже показывает упрощенную работу MCP.
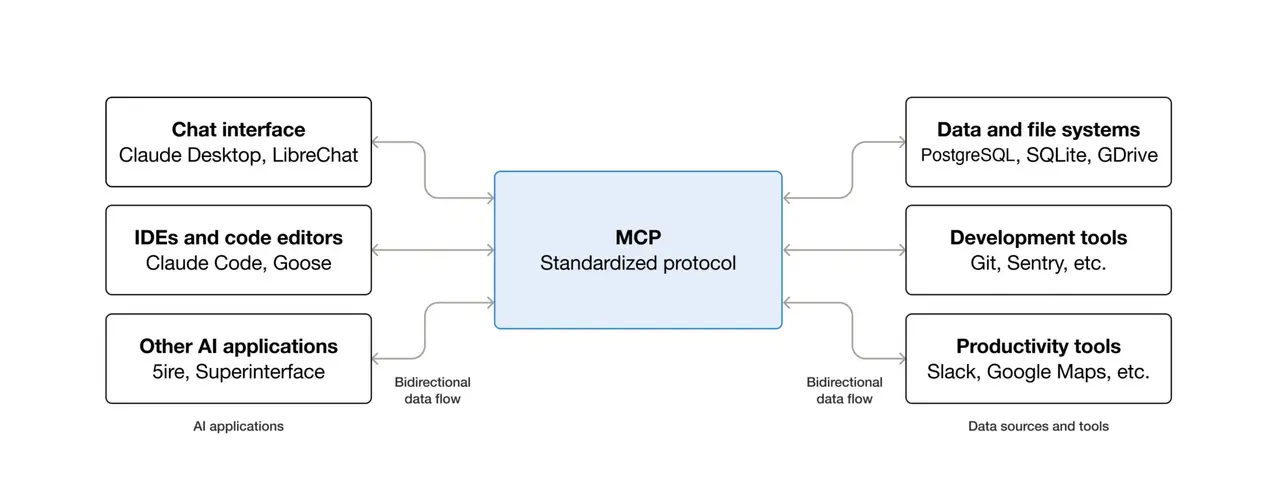
Многие специализированные агенты не имеют систем защиты, которые могли бы смягчить наиболее опасные последствия инъекции команд. Поскольку серверы MCP хранят учетные данные каждого агента, а агенты созданы для доверия ко всем другим внутренним агентам, эксплойт, который был бы отклонен LLM, успешно срабатывает. Во многих случаях хорошо составленные команды, нацеленные на нужного агента, приводят к подделке серверных запросов (server-side request forgery) — уязвимости, которая заставляет веб-сервер выполнять несанкционированные сетевые запросы.
,
«ИИ-агенты предоставляют злоумышленникам новый набор соединений для перемещения», — рассказал Арс Дуглас Макки, директор по разведке уязвимостей в Rapid7. «Кто-то внедряет текст в контент, агент считывает его, а затем передает другому агенту как обычную делегированную задачу, и второй агент выполняет ее, потому что доверяет тому, кто передал ему работу. Каждый элемент в этой цепочке делал именно то, для чего был создан, и именно это делает эту проблему такой сложной для обнаружения. Каждый протокол был разработан с предположением, что он работает изолированно, поэтому каждый проверяет свою собственную входную дверь, в то время как никто не следит за коридором между ними».
Уязвимость CVE-2026-97228, обнаруженная Мохиуддином в сети Rapid7, имела рейтинг серьезности всего 2,7 из 10. Rapid7 исправила ее в прошлом месяце.
Уязвимость, затронувшая Google, была более серьезной, с рейтингом 8. Она возникла из-за того, что набор инструментов MCP для баз данных (googleapis/mcp-toolbox) инициализировал свой HTTP-клиент без использования политики CheckRedirect — набора настроек, контролирующих, как сервер должен обрабатывать случаи, когда URL возвращает ошибку или перенаправляет на другой URL. HTTP-клиент Google также не смог проверить целевые IP-адреса.
«Сконструированный параметр пути мог заставить набор инструментов следовать перенаправлению на внутреннюю конечную точку и отправлять запросы от имени злоумышленника», — пояснил Мохиуддин. Исправление Google включало применение списка разрешенных диапазонов IP-адресов и списков блокировки. «Он отклоняет небезопасный базовый URL при запуске, а не при первом запросе. Вот как выглядит настоящая защита от SSRF. Это также требует больше работы, чем выполнено большинством серверов MCP».
Мохиуддин называет этот класс атак «протокольным пивотингом» (protocol pivoting), поскольку эксплойты работают, когда приложение или сервер использует MCP для назначения задачи агенту, а агент затем пересылает вредоносные инструкции другому агенту, используя другой метод связи, такой как протокол Agent-to-Agent (A2A) от Google, используемый для меж-агентской делегации, или новые стандарты, такие как Agent Network Protocol. Часто, по его словам, доверие или авторизация фактически теряются при передаче. Он описал протокольный пивотинг как «многоступенчатую атаку, в которой злоумышленник получает первоначальный доступ через один протокол, использует предположения о доверии между протоколами и эскалирует свои возможности, доступные только через другой протокол».
,
Маркус Вервье, исследователь из X41 D-Sec, который также разрабатывал ИИ-атаки, использующие MCP, считает, что более подходящим термином остается «инъекция команд» (prompt injection), а техника Мохиуддина является ее простым подклассом.
«Для меня это косвенная инъекция команд», — сказал он Арс. «Тот факт, что вредоносная команда может исходить из другого протокола (например, A2A) и проявляться при использовании через другой протокол, не является строго обязательным для работы таких атак. Это, конечно, неожиданно и в целом трудно устранимо».
Тот факт, что техника пивотинга сработала в пяти организациях, не имеющих ничего общего, кроме использования MCP, заслуживает внимания. MCP — новый протокол, и он уже повсеместно распространен до того, как был достаточно протестирован и укреплен. В спешке организаций по созданию разветвленных агентных архитектур они отказались от основного принципа безопасности, известного как нулевое доверие (zero trust). Согласно этой модели, сети строятся исходя из предположения, что один или несколько узлов могут быть заражены. Для смягчения последствий инженеры должны проектировать узлы так, чтобы они требовали авторизации перед проведением конфиденциальных транзакций с другими узлами.
«Урок, который я хотел бы донести до людей, заключается в том, что все, что передается из LLM в ваш инструмент, следует рассматривать как ввод от незнакомца в Интернете, потому что в сценарии инъекции команд это именно то, чем оно является», — сказал Макки. «Лежащие в основе ошибки — это старые знакомые, такие как инъекции и SSRF, и исправления не менялись уже 20 лет. Честь исследователю за то, что он дал этому название, потому что именно название заставляет защитников и стандартизирующие органы действительно проектировать решения для этого».
Всегда имейте в виду, что редакции могут придерживаться предвзятых взглядов в освещении новостей.
Автор – Dan Goodin


